O software de automação de atendimento ao cliente deixou para trás o bot com script que comparava uma pergunta com uma árvore de decisão e desistia quando a formulação mudava. A versão que vale a pena comprar hoje fica ao lado do agente, lê toda a conversa, redige uma resposta e a entrega para revisão.
Essa mudança altera a pergunta de compra. Não se trata mais de saber se a ferramenta consegue responder, mas de quanto da resposta ela prepara, quanto ainda pertence a uma pessoa e quem paga o provedor do modelo quando o volume cresce.
O que faz o software de automação de atendimento ao cliente
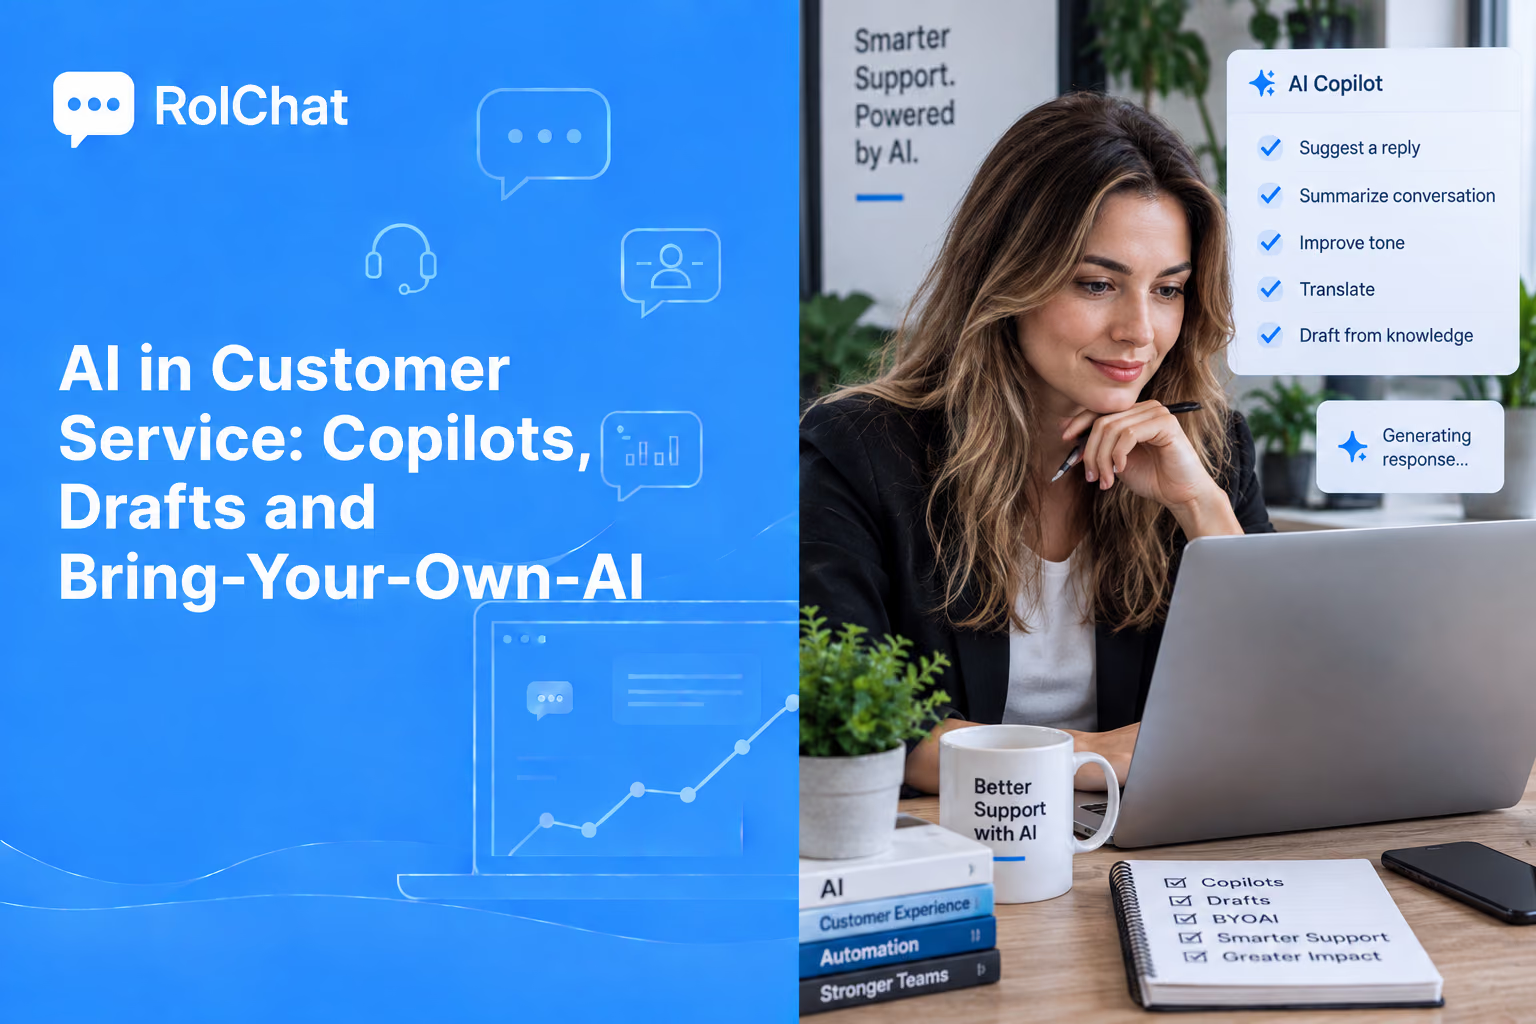
Por trás do nome da categoria há uma pequena lista de tarefas concretas: resumir uma conversa longa em três linhas, redigir uma resposta baseada no seu próprio conteúdo de ajuda, classificar a intenção e rotear de acordo, detectar sentimento, traduzir em ambas as direções e marcar a conversa para que os relatórios tenham algo a contar.
Nenhuma dessas tarefas é dramática por si só. Cada uma elimina um atraso ou uma etapa manual, e os atrasos são o que os clientes sentem.
O efeito cumulativo aparece com as novas contratações. Uma pessoa em sua segunda semana responde quase no padrão de alguém em seu segundo ano, porque o rascunho já traz a política, o histórico da conta, o tom certo e os últimos três pedidos.
Automação aqui não significa respostas não supervisionadas por padrão. Todas as capacidades abaixo pressupõem que uma pessoa possa ver o rascunho antes de ele ser enviado, e a plataforma é configurada para que esse seja o caminho normal, e não a exceção.
Três níveis de automação, e qual comprar
Os fornecedores usam as mesmas palavras para comportamentos muito diferentes, então ajuda separar os níveis por quem é responsável pela mensagem enviada.
| Nível | Quem escreve | Quem envia | Como falha |
|---|---|---|---|
| Fluxo com script | Você, antecipadamente | O sistema | Não reconhecer a pergunta |
| Copiloto | O modelo | O agente | Desperdiçar um clique de revisão |
| Agente autônomo | O modelo | O sistema | Enviar uma resposta errada |
Os fluxos com script ainda merecem seu lugar nas perguntas estreitas e de alto volume, cuja formulação varia pouco: status do pedido, horário de funcionamento, redefinição de senha.
O copiloto é o padrão para tudo o mais, porque seu pior resultado custa alguns segundos, enquanto o pior resultado do agente autônomo custa um cliente.
Melhor para a maioria das equipes: fluxos com script para as cinco perguntas repetidas mais comuns, copiloto em todo o resto, autônomo apenas onde uma resposta errada é barata de reverter.
O modelo de copiloto na caixa de entrada
No padrão de copiloto, o modelo prepara e o agente decide. O rascunho aparece ao lado da conversa com suas fontes anexadas, e o agente edita, substitui ou envia.
A etapa de revisão não é uma formalidade. É o controle que mantém uma resposta errada ocasional dentro da sua empresa, em vez de na caixa de entrada do seu cliente.
Ela também produz o sinal que indica se a automação está funcionando. Cada edição é uma correção rotulada, e a taxa dessas edições é a métrica de qualidade honesta descrita mais adiante.
Onde a automação vai além da caixa de resposta
Tratar a IA como um widget acoplado ao chat ao vivo desperdiça a maior parte do seu potencial. A mesma camada tem trabalho a fazer em todos os módulos que tocam uma conversa.
Na base de conhecimento, ela redige artigos a partir de conversas resolvidas e sinaliza páginas que contradizem respostas mais recentes. Um software de base de conhecimento de suporte ao cliente que nunca percebe sua própria desatualização é o motivo usual pelo qual o autoatendimento deixa de desviar qualquer coisa.
No roteamento, ela lê a intenção antes de um humano fazê-lo, para que uma pergunta de faturamento chegue à fila de faturamento sem passar por uma etapa de triagem.
Nos relatórios, ela agrupa conversas pelo que os clientes realmente perguntaram, em vez de pela tag que um agente se lembrou de aplicar, o que é o que transforma uma contagem de tickets em uma decisão de produto.
No trabalho de saída, a mesma classificação orienta os segmentos de campanha, de modo que as pessoas que acabaram de reclamar não sejam as que recebem a oferta de upsell.
A cobertura entre módulos também determina quanto do seu próprio material o assistente consegue acessar. Um assistente que vê apenas o chat atual escreve a partir do chat atual, e um assistente que vê o cadastro do cliente, o histórico de pedidos e os últimos três tickets escreve a partir de tudo isso.
Traga sua própria IA: quem detém a conta do modelo
Duas perguntas se misturam em quase toda demonstração. O que o assistente consegue fazer é uma questão de produto. Quem detém a conta com o provedor do modelo é uma questão comercial, e ela decide se uma automação melhor reduz seu custo total ou o aumenta.
Quando a plataforma detém a conta, o uso do modelo chega como um item de linha da plataforma, geralmente como créditos ou assentos. O custo então sobe com o sucesso: quanto mais conversas a IA lida, mais você compra do fornecedor, na margem do fornecedor.
Trazer sua própria IA inverte isso. Você conecta suas próprias chaves de provedor, os tokens são cobrados diretamente de você pelo provedor, e a plataforma não aplica margem sobre eles. A RolChat funciona assim em 62 modelos de texto de sete provedores e 23 modelos de voz de quatro, 85 no total.
Com uma chave própria (bring-your-own-key), uma melhoria que dobra o volume automatizado dobra uma fatura do provedor que você pode ver e negociar. Com créditos empacotados, a mesma melhoria dobra uma linha em uma fatura cujo preço unitário você não define.
O custo de tokens acompanha o contexto, não as conversas
Equipes novas em ter sua própria chave costumam esperar que a fatura acompanhe o número de conversas. Na verdade, ela acompanha o comprimento do contexto.
Uma resposta redigida a partir das últimas quatro mensagens custa uma fração da mesma resposta redigida a partir de uma conversa de sessenta mensagens, e um resumo dessa conversa inteira custa mais do que qualquer uma das duas.
Três configurações, portanto, fazem a maior parte do trabalho: até onde a janela de contexto alcança, se os resumos rodam em toda conversa ou apenas nas longas, e se a recuperação busca três artigos de ajuda ou trinta.
Nada disso é visível em uma página de comparação de planos. É visível no painel do provedor na primeira semana, o que é o argumento para manter a conta você mesmo.
Escolhendo um modelo por tarefa
Um único modelo para toda tarefa é o padrão caro. O trabalho se divide claramente conforme o quanto de julgamento cada tarefa exige.
| Tarefa | Precisa de | Escolha sensata |
|---|---|---|
| Marcação e intenção | Velocidade, baixo custo, saída estável | Um modelo pequeno e rápido |
| Redação de respostas | Tom, raciocínio sobre o histórico | Um modelo médio ou grande |
| Política e reembolsos | Cuidado, redação exata | O modelo mais forte disponível |
| Tradução | Cobertura dos seus idiomas | O provedor que melhor os cobrir |
Dividir dessa forma geralmente reduz a fatura mais do que qualquer ajuste de prompt, porque as tarefas de alto volume são as baratas e o modelo caro roda apenas onde ele justifica seu preço.
Uma divisão prática para começar: modelo rápido para classificação e marcação, modelo médio para rascunhos, modelo mais forte reservado para dinheiro e política.
Mudanças de roteamento antes de qualquer rascunho ser escrito
A maior parte do ganho visível acontece antes que alguém escreva uma palavra. A classificação ocorre na chegada, então a conversa já está marcada, já está na fila certa e já carrega uma prioridade quando um agente a abre.
Isso elimina o turno de triagem, que é a etapa que as equipes adicionam quando o volume cresce e removem quando ficam sem pessoal para fazê-la.
Isso também muda o que um SLA mede. Um relógio que começa quando um humano lê a mensagem pela primeira vez recompensa a velocidade de triagem. Um relógio que começa na chegada recompensa aquilo com que os clientes realmente se importam, e a classificação automatizada é o que torna o segundo caso viável.
O segundo efeito está na escalação. Quando a intenção e o sentimento são atribuídos desde a primeira mensagem, a regra que encaminha uma conversa de faturamento irritada para um agente sênior pode disparar imediatamente, em vez de na segunda resposta.
Vale verificar em uma demonstração: se a classificação roda na chegada ou na primeira abertura, porque apenas a primeira opção elimina a etapa de triagem.
Dados que o assistente nunca deve acessar
Fundamentar um assistente no seu próprio conteúdo significa decidir o que conta como seu próprio conteúdo. Conversas resolvidas são o material de treinamento mais útil e o mais propenso a conter números de cartão e documentos de identidade que os clientes colaram em um chat.
Três controles carregam a maior parte do peso: redação (mascaramento de dados) antes que qualquer coisa chegue ao modelo, limites de retenção sobre as transcrições, e uma regra de que o assistente recupera informações de artigos de ajuda publicados, e não de conversas brutas.
O consentimento pertence à mesma decisão. A RolChat trata isso como um complemento pago a $5 por site, com três consentimentos por site, e não está disponível no plano Lite.
As solicitações de exclusão são o caso que pega as equipes desprevenidas. Um registro removido do helpdesk, mas ainda presente em um índice vetorial, ainda é um registro, então verifique se uma exclusão chega à recuperação e não apenas à lista de tickets.
Mantendo respostas precisas e alinhadas à marca
Duas configurações separam o resultado que você pode enviar do resultado que você precisa reescrever.
A primeira é o embasamento. As respostas são redigidas a partir de material aprovado: artigos de ajuda e conversas resolvidas, e o rascunho carrega as fontes que usou. Uma resposta sem fonte por trás é um palpite vestindo um tom confiante.
A segunda é a voz. Uma configuração de tom e um glossário de termos que você usa e não usa mantêm os rascunhos soando como a sua equipe, e não como um assistente genérico.
O glossário importa ainda mais entre idiomas. Nomes de produtos e termos jurídicos são exatamente as palavras que uma camada de tradução vai traduzir prestativamente, a menos que seja instruída a não fazê-lo.
A RolChat cobre 40 idiomas de interface e widget, e o mesmo glossário se aplica a todos eles.
Voz: a mesma pergunta, um prazo mais apertado
A voz eleva a aposta porque não há rascunho para revisar. A resposta é falada à medida que é gerada, então o embasamento precisa estar correto de antemão, em vez de corrigido no momento.
A divisão prática é por consequência. Conversão de fala em texto em toda chamada, porque uma transcrição é útil mesmo quando imperfeita. Respostas automatizadas faladas apenas onde errar é barato: horários, status, roteamento.
Os minutos de chamada são cobrados separadamente do plano na RolChat, então o volume de voz é uma linha que você acompanha por conta própria, em vez de uma surpresa dentro do preço de um assento.
A ordem de implementação importa tanto quanto as configurações. Equipes que ativam tudo de uma vez não conseguem dizer qual mudança moveu qual número, e acabam mantendo tudo ou nada disso.
A sequência que se lê com clareza é classificação primeiro, depois rascunhos em uma fila, depois rascunhos em todo lugar, depois qualquer tratamento autônomo. Cada etapa tem seu próprio antes e depois.
Medindo se a automação funcionou
A taxa de desvio (deflection rate) é a métrica com que os fornecedores lideram e a menos útil, porque uma conversa que termina sem um humano pode terminar em uma resposta ou em um cliente desistindo.
Quatro números dizem mais. Taxa de edição nos rascunhos, que cai conforme o embasamento melhora. Tempo de primeira resposta, onde o copiloto se paga. Taxa de reabertura, que pega respostas que só pareciam concluídas. Avaliação do cliente dividida entre atendimento automatizado e humano.
Leia-os junto com a fatura do provedor do mesmo período. Qualidade que melhora enquanto o custo por conversa cai é o resultado que vale a pena manter; qualquer um dos dois isoladamente não é.
Todos os quatro números precisam de uma leitura de antes da implementação. Equipes que pulam a linha de base acabam discutindo se algo mudou, sem como resolver isso.
Limites que vale a pena declarar com clareza
Dois limites valem a pena declarar com clareza. A implantação on-premise é um arranjo Enterprise, não algo disponível nos planos inferiores. Modelos rodando no seu próprio hardware estão planejados, e não disponíveis, então uma exigência de inferência local hoje é uma exigência que a RolChat não atende.
O preço é por empresa, e não por agente, de $19 no Lite ao Enterprise, cujo preço é sob consulta, e o teste gratuito de 30 dias abre todos os recursos com um cartão cadastrado.
A automação também é mais fácil de avaliar quando os canais por trás dela já estão em um só lugar, o que é o assunto do guia complementar.
Perguntas frequentes
O que o software de automação de atendimento ao cliente realmente automatiza?
Resumir conversas, redigir respostas a partir de conteúdo aprovado, classificar intenção, rotear, marcar e traduzir. No padrão de copiloto, ele prepara tudo isso e um agente decide o que é enviado.
A IA vai substituir os agentes de atendimento ao cliente?
Não no modelo de copiloto, que é o padrão que a maioria das equipes deve adotar. O modelo redige e o agente revisa e envia. O que desaparece é a preparação repetitiva, não a pessoa responsável pela resposta.
O que é trazer sua própria IA (bring-your-own-AI)?
Você conecta suas próprias chaves de provedor, então os tokens são cobrados diretamente de você pelo provedor, sem margem da plataforma. Isso também significa que você pode trocar de modelo ou provedor sem trocar de helpdesk.
Quanto custa rodar a IA?
Depende muito mais do comprimento do contexto do que do número de conversas. Conversas longas, resumos em toda conversa, recuperação ampla e re-resumos repetidos são as configurações que movem a fatura, e todas as três estão sob seu controle.
Qual modelo deve tratar qual tarefa?
Um modelo pequeno e rápido para marcação e intenção, um modelo médio ou grande para rascunhos, e o modelo mais forte disponível para reembolsos e redação de políticas. Dividir por tarefa geralmente economiza mais do que ajustar prompts.
Como impedir que a IA invente respostas?
Fundamente-a em conteúdo de ajuda aprovado para que cada rascunho carregue suas fontes, mantenha a etapa de revisão em vigor e acompanhe a taxa de edição e a taxa de reabertura após o lançamento, em vez de apenas a taxa de desvio.
Os modelos podem rodar em nossos próprios servidores?
A implantação on-premise está disponível no Enterprise. Modelos autoalojados estão planejados, e não disponíveis hoje, então uma exigência rígida de inferência local ainda não é atendida.
A automação funciona entre idiomas?
Sim. Ela cobre 40 idiomas de interface e widget, com tradução em ambas as direções. Mantenha termos de produto e jurídicos em um glossário para que a camada de tradução não os altere.
Escreve sobre operações de atendimento ao cliente, chat ao vivo, serviço assistido por IA e as ferramentas por trás de uma boa experiência do cliente.
LinkedIn