ChatGPT
 Perplexity
 Grok
 Claude
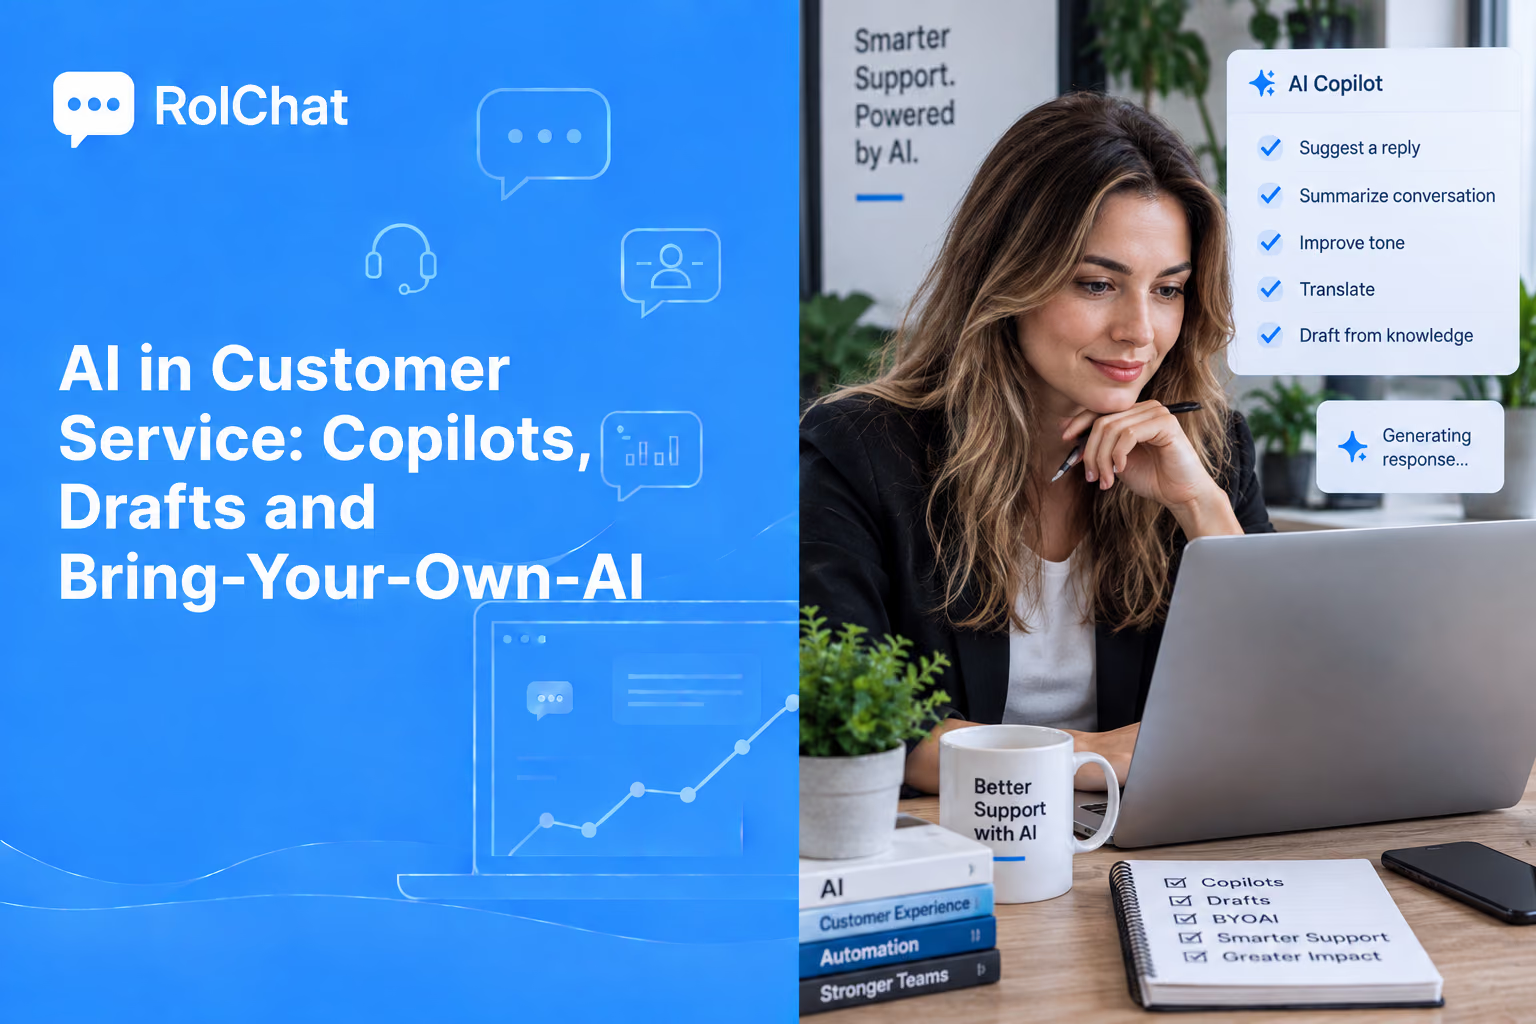
カスタマーサービス自動化ソフトウェアは、質問を決定木と照合し、言い回しが変わると対応できなくなる台本通りのボットの段階をすでに超えています。今買う価値があるバージョンは、担当者の隣に座り、スレッド全体を読み、回答を下書きしてレビューのために渡します。
この変化は購入時の問いを変えます。もはやツールが回答できるかどうかではなく、回答のどこまでを準備するのか、どこまでを依然として人が担うのか、そして利用量が増えたときに誰がモデル提供元に支払うのか、という問いになります。
カスタマーサービス自動化ソフトウェアが行うこと
このカテゴリー名の裏には、具体的な仕事の短いリストがあります。長いスレッドを3行に要約します。自社のヘルプコンテンツに基づいて返信を下書きします。意図を分類し、それに応じてルーティングします。感情を検出します。双方向で翻訳します。会話にタグを付け、レポートが何かを集計できるようにします。
そのどれ一つを取っても劇的ではありません。それぞれが一つの遅延、一つの手作業のステップを取り除くだけですが、その遅延こそ顧客が感じ取るものです。
その効果の積み重ねは新人に表れます。入社2週目の担当者が、2年目の担当者に近い水準で回答できるようになります。なぜなら下書きにはすでにポリシー、アカウント履歴、適切なトーン、直近3件の注文が反映されているからです。
ここでの自動化は、初期設定として無人で送信することを意味しません。以下のすべての機能は、送信前に人が下書きを確認できることを前提としており、プラットフォームはそれを例外ではなく通常の流れとして設定されます。
自動化の3つのレベルと、どれを選ぶべきか
ベンダーは全く異なる挙動に同じ言葉を使うため、送信されたメッセージについて誰が責任を負うかでレベルを分けると理解しやすくなります。
| レベル | 誰が書くか | 誰が送るか | 失敗の仕方 |
|---|---|---|---|
| 台本型フロー | あなたが事前に | システム | 質問を認識できない |
| コパイロット | モデル | 担当者 | レビューのクリックを無駄にする |
| 自律エージェント | モデル | システム | 誤った回答を送る |
台本型フローは、言い回しがほとんど変わらない、範囲が狭く量の多い質問においては今も居場所があります。注文状況、営業時間、パスワードのリセットなどです。
コパイロットはそれ以外すべてにおいて既定の選択肢となります。最悪の結果が数秒の無駄で済むのに対し、自律エージェントの最悪の結果は顧客を失うことにつながるからです。
ほとんどのチームに最適なのは:頻出質問上位5つには台本型フロー、それ以外はコパイロット、誤答を覆すコストが低い場合に限り自律型を使うことです。
受信箱におけるコパイロットモデル
コパイロットのパターンでは、モデルが準備し、担当者が判断します。下書きはソース情報を添えて会話の隣に表示され、担当者はそれを編集、差し替え、あるいは送信します。
レビューのステップは形式的なものではありません。それは、時折発生する誤った回答を顧客の受信箱ではなく自社内にとどめておくための制御手段です。
またこれは、自動化がうまく機能しているかを示すシグナルも生み出します。すべての編集はラベル付けされた訂正であり、その編集の割合こそ、後ほど述べる正直な品質指標となります。
自動化が返信欄の外にまで及ぶ場所
AIをライブチャットに取り付けただけのウィジェットとして扱うと、その大半が無駄になります。同じレイヤーは、会話に関わるあらゆるモジュールで果たすべき役割を持っています。
ナレッジベースでは、解決済みのスレッドから記事を下書きし、より新しい回答と矛盾するページにフラグを立てます。自らの古さに気づかないカスタマーサポート向けナレッジベースソフトウェアが、セルフサービスが何も捌けなくなる典型的な原因です。
ルーティングでは、人が対応する前に意図を読み取るため、請求に関する質問はトリアージのステップを経ずに請求担当のキューに届きます。
レポートでは、担当者が思い出してつけたタグではなく、顧客が実際に尋ねた内容によって会話をグループ化します。これがチケット数を製品に関する意思決定に変える要因です。
アウトバウンドの業務では、同じ分類がキャンペーンのセグメントを決定するため、直前にクレームを入れた人がアップセルの対象になることはありません。
モジュール横断のカバー範囲は、アシスタントが自社のどの資料に届くかも左右します。現在のチャットしか見えないアシスタントは現在のチャットだけを基に書き、顧客情報、注文履歴、直近3件のチケットまで見えるアシスタントはそのすべてを基に書きます。
自前AI持ち込み:モデルのアカウントを誰が持つか
ほとんどすべてのデモで、2つの問いが混同されています。アシスタントに何ができるかは製品面の問いです。モデル提供元とのアカウントを誰が持つかは商業面の問いであり、これが自動化の改善が総コストを下げるのか上げるのかを決めます。
プラットフォームがアカウントを持つ場合、モデルの利用はプラットフォームの請求項目として、通常クレジットまたは席数の形で現れます。その場合、コストは成功とともに上昇します。AIが処理する会話が増えるほど、ベンダーのマージン込みでより多くをベンダーから購入することになります。
自前AI持ち込みはこれを逆転させます。自分自身のプロバイダーのキーを接続し、トークンはプロバイダーから直接あなたに請求され、プラットフォームはそこにマージンを乗せません。RolChatはこの方式で、7社のプロバイダーのテキストモデルと4社の音声モデルにわたって機能します。
自前キー方式では、自動化量を倍増させる改善は、あなたが見て交渉できるプロバイダーの請求書を倍増させます。バンドルされたクレジット方式では、同じ改善は、自分では単価を決められない請求書上の一項目を倍増させるだけです。
トークンコストは会話数ではなくコンテキストで決まる
自前キーに初めて触れるチームは、通常、請求額が会話数に連動すると考えがちです。しかし実際に連動するのはコンテキストの長さです。
直近4件のメッセージから下書きされた返信は、60件のスレッドから下書きされた同じ返信のごく一部のコストで済み、そのスレッド全体の要約はどちらよりも高くつきます。
したがって、3つの設定が仕事の大部分を左右します。コンテキストウィンドウがどこまで遡るか、要約をすべてのスレッドで実行するか長いものだけで実行するか、そして検索がヘルプ記事を3件引くのか30件引くのかです。
そのいずれもプラン比較ページには表示されません。最初の週にプロバイダーのダッシュボード上で見えてくるものであり、それがアカウントを自分で持つことの根拠となります。
タスクごとにモデルを選ぶ
すべての業務に単一のモデルを使うのは、コストのかかる既定の選択です。各タスクにどれほどの判断力が必要かによって、作業はきれいに分かれます。
| タスク | 求めるもの | 妥当な選択 |
|---|---|---|
| タグ付けと意図分類 | 速度、低コスト、安定した出力 | 小規模で高速なモデル |
| 返信の下書き | トーン、履歴を踏まえた推論 | 中規模または大規模なモデル |
| ポリシーと返金 | 慎重さ、正確な言い回し | 利用可能な最も強力なモデル |
| 翻訳 | 対象言語のカバー範囲 | それらを最もよくカバーするプロバイダー |
このように分割すると、通常はどんなプロンプト調整よりも請求額を削減できます。なぜなら量の多いタスクは安価なものであり、高価なモデルはその価格に見合う場所でのみ動作するからです。
実用的な出発点となる分担:分類とタグ付けには高速モデル、下書きには中規模モデル、金銭とポリシーには最も強力なモデルを取っておきます。
下書きが書かれる前に変わるルーティング
目に見える成果の大部分は、誰かが一語でも書く前に生まれます。分類は到着時点で行われるため、担当者が会話を開いた時点で、すでにタグが付き、適切なキューに入り、優先度も設定されています。
これによりトリアージのシフトが不要になります。トリアージは、量が増えたときにチームが追加し、それに割く人手がなくなったときに削るステップです。
これはSLAが何を測るかも変えます。人が最初にメッセージを読んだ時点で始まる時計はトリアージの速さに報います。到着時点で始まる時計は顧客が本当に気にすることに報いるものであり、自動分類こそが後者を成り立たせるものです。
2つ目の効果はエスカレーションに関するものです。意図と感情が最初のメッセージから付与されていれば、怒った請求関連のスレッドを上級担当者へ回すルールは、2回目の返信を待たずに即座に発動できます。
デモで確認する価値があるのは、分類が到着時点で実行されるのか、それとも最初に開いたときに実行されるのかです。前者だけがトリアージのステップを取り除きます。
アシスタントに触れさせてはいけないデータ
アシスタントを自社のコンテンツに基づかせるということは、何が自社コンテンツに含まれるかを決めることでもあります。解決済みの会話は最も有用な学習材料であると同時に、顧客がチャットに貼り付けたカード番号や身分証明書が含まれている可能性が最も高いものでもあります。
3つの制御が重要な役割の大半を担います。モデルに何かが届く前の匿名化処理、トランスクリプトの保持期間の制限、そしてアシスタントが生のスレッドではなく公開済みのヘルプ記事から検索するというルールです。
同意の取り扱いも同じ意思決定の一部です。RolChatは同意管理を、Liteを含むすべてのプランでサイトごとに$5のアドオンとして提供しています。
削除リクエストは、チームが見落としがちなケースです。ヘルプデスクから削除されたレコードでも、ベクトルインデックスに残っていればそれは依然としてレコードです。したがって削除がチケット一覧だけでなく検索対象にも及んでいるか確認してください。
回答の正確さとブランドらしさを保つ
そのまま送信できる出力と、書き直さなければならない出力を分ける設定は2つあります。
1つ目はグラウンディングです。回答は承認済みの資料、すなわちヘルプ記事や解決済みの会話から下書きされ、その下書きは使用したソースを添えて表示されます。裏付けのない回答は、自信ありげな口調をまとった単なる推測にすぎません。
2つ目はボイスです。トーンの設定と、使う用語・使わない用語の用語集によって、下書きが汎用的なアシスタントではなく自社のチームらしく響くようになります。
用語集は言語をまたぐとさらに重要になります。製品名や法律用語は、指定しない限り翻訳レイヤーが親切に翻訳してしまうまさにその言葉だからです。
RolChatはインターフェースとウィジェットで40言語をカバーしており、同じ用語集がそのすべてに適用されます。
音声:同じ質問、より厳しい締め切り
音声は状況の緊張度を高めます。レビューする下書きが存在しないからです。返信は生成されると同時に話されるため、グラウンディングはその場で修正するのではなく、事前に正しくしておく必要があります。
実務上の使い分けは結果次第で決まります。すべての通話で音声のテキスト化を行うべきです。トランスクリプトは完璧でなくても役に立つからです。自動音声応答は、誤っても影響が小さい場面に限ります。営業時間、ステータス、ルーティングなどです。
RolChatの電話機能は近日提供予定です。提供後、通話分数はプランとは別に請求されるので、音声の利用量は席数の価格に紛れ込む想定外の出費ではなく、個別に確認できる項目になります。
展開の順序は設定と同じくらい重要です。すべてを一度に有効化するチームは、どの変更がどの数字を動かしたのか判別できず、結局すべてを維持するか、すべてをやめるかのどちらかに陥ります。
すっきりと読み解ける順序は、まず分類、次に1つのキューでの下書き、次にすべてでの下書き、最後に自律的な対応という流れです。各ステップにはそれぞれの前後比較があります。
自動化が機能したかどうかを測る
デフレクション率はベンダーが真っ先に持ち出す指標であり、最も役に立たない指標でもあります。人を介さずに終わった会話は、回答が得られて終わったのか、顧客が諦めて終わったのかを区別できないからです。
より多くを語る数字が4つあります。下書きの編集率はグラウンディングが改善するにつれて下がります。初回応答時間はコパイロットが元を取る場所です。再オープン率は、完了したように見えただけの回答を捕捉します。そして自動対応と人的対応で分けた顧客評価です。
これらを同じ期間のプロバイダー請求額と照らし合わせて読んでください。会話あたりのコストが下がりながら品質が向上するのが維持する価値のある結果であり、どちらか一方だけではそうとは言えません。
この4つの数字はすべて、展開前の測定値が必要です。基準値を省いたチームは、何かが変わったかどうかを巡って結局言い争うことになり、決着をつける手段を持ちません。
率直に述べておくべき制限
率直に述べておく価値のある制限が2つあります。オンプレミス展開はEnterpriseの契約であり、下位プランでは利用できません。自社ハードウェア上で動くモデルは計画段階であり、まだ利用可能ではありません。したがって今日ローカル推論を必須要件とする場合、それはRolChatが満たせない要件です。
料金は担当者単位ではなく企業単位で、Liteの19ドルからとなり、Enterpriseは個別見積もり、そして30日間の無料トライアルがあります。
自動化の裏側にあるチャネルがすでに一箇所にまとまっていれば、自動化の評価もしやすくなります。それが姉妹編ガイドのテーマです。
よくある質問
カスタマーサービス自動化ソフトウェアは実際に何を自動化するのですか?
スレッドの要約、承認済みコンテンツからの返信の下書き、意図の分類、ルーティング、タグ付け、翻訳です。コパイロットのパターンでは、それらすべてを準備し、何を送るかは担当者が判断します。
AIはカスタマーサービス担当者に取って代わるのですか?
ほとんどのチームが採用すべきパターンであるコパイロットモデルではそうなりません。モデルが下書きし、担当者がレビューして送信します。なくなるのは反復的な準備作業であって、回答に責任を持つ人ではありません。
自前AI持ち込みとは何ですか?
自分自身のプロバイダーキーを接続することで、トークンはプラットフォームによるマージンなしにプロバイダーから直接あなたに請求されます。またこれにより、ヘルプデスクを変更せずにモデルやプロバイダーを変更できます。
AIの運用にはどれくらいコストがかかるのですか?
会話数よりもコンテキストの長さがはるかに大きく影響します。長いスレッド、すべての会話での要約、広範な検索、繰り返しの再要約が請求額を動かす設定であり、この3つはすべて自分で設定できるものです。
どのモデルにどのタスクを担当させるべきですか?
タグ付けと意図分類には小型の高速モデル、下書きには中規模または大規模モデル、返金やポリシーの文言には利用可能な最も強力なモデルを使います。タスクごとに分けることは通常、プロンプト調整よりも大きな節約になります。
AIが回答をでっち上げるのをどう防ぐのですか?
承認済みのヘルプコンテンツに基づかせ、すべての下書きにソースを添え、レビューのステップを維持し、公開後はデフレクションだけでなく編集率と再オープン率を追跡します。
モデルは自社のサーバー上で動かせますか?
オンプレミス展開はEnterpriseで利用できます。セルフホスト型のモデルは現時点では計画段階であり利用できないため、ローカル推論を必須要件とする場合はまだ満たされません。
自動化は複数の言語にまたがって機能しますか?
はい。インターフェースとウィジェットで40言語をカバーしており、双方向の翻訳に対応しています。翻訳レイヤーがそのままにしておくよう、製品名や法律用語は用語集に保持してください。