Le logiciel d'automatisation du service client a dépassé le stade du bot scripté qui comparait une question à un arbre de décision et abandonnait dès que la formulation changeait. La version qui vaut la peine d'être achetée aujourd'hui se place aux côtés de l'agent, lit l'ensemble du fil, rédige une réponse et la transmet pour relecture.
Ce changement modifie la question d'achat. Il ne s'agit plus de savoir si l'outil peut répondre, mais de savoir quelle part de la réponse il prépare, quelle part reste sous la responsabilité d'une personne, et qui paie le fournisseur du modèle quand le volume augmente.
Ce que fait un logiciel d'automatisation du service client
Derrière le nom de la catégorie se cache une courte liste de tâches concrètes. Résumer un long fil en trois lignes. Rédiger une réponse ancrée dans votre propre contenu d'aide. Classifier l'intention et router en conséquence. Détecter le sentiment. Traduire dans les deux sens. Étiqueter la conversation pour que le reporting ait quelque chose à compter.
Aucune de ces actions n'est spectaculaire en soi. Chacune supprime un délai ou une étape manuelle, et ce sont les délais que les clients ressentent.
L'effet cumulatif se manifeste chez les nouvelles recrues. Une personne dans sa deuxième semaine répond à un niveau proche de celui d'une personne dans sa deuxième année, parce que le brouillon porte déjà la politique, l'historique du compte, le bon ton et les trois dernières commandes.
L'automatisation ici ne signifie pas des réponses non supervisées par défaut. Chaque fonctionnalité ci-dessous suppose qu'une personne peut voir le brouillon avant son envoi, et la plateforme est configurée pour que ce soit le chemin normal plutôt que l'exception.
Trois niveaux d'automatisation, et lequel choisir
Les éditeurs utilisent les mêmes mots pour des comportements très différents, il est donc utile de distinguer les niveaux selon qui est responsable du message envoyé.
| Niveau | Qui rédige | Qui envoie | Échoue par |
|---|---|---|---|
| Flux scripté | Vous, à l'avance | Le système | Ne pas reconnaître la question |
| Copilote | Le modèle | L'agent | Gaspiller un clic de relecture |
| Agent autonome | Le modèle | Le système | Envoyer une mauvaise réponse |
Les flux scriptés méritent encore leur place sur les questions étroites et à fort volume dont la formulation varie à peine : statut de commande, horaires d'ouverture, réinitialisation de mot de passe.
Le copilote est le choix par défaut pour tout le reste, car son pire scénario coûte quelques secondes, tandis que celui de l'agent autonome coûte un client.
Idéal pour la plupart des équipes : flux scriptés sur les cinq questions récurrentes principales, copilote partout ailleurs, autonomie uniquement là où une mauvaise réponse est peu coûteuse à corriger.
Le modèle du copilote dans la boîte de réception
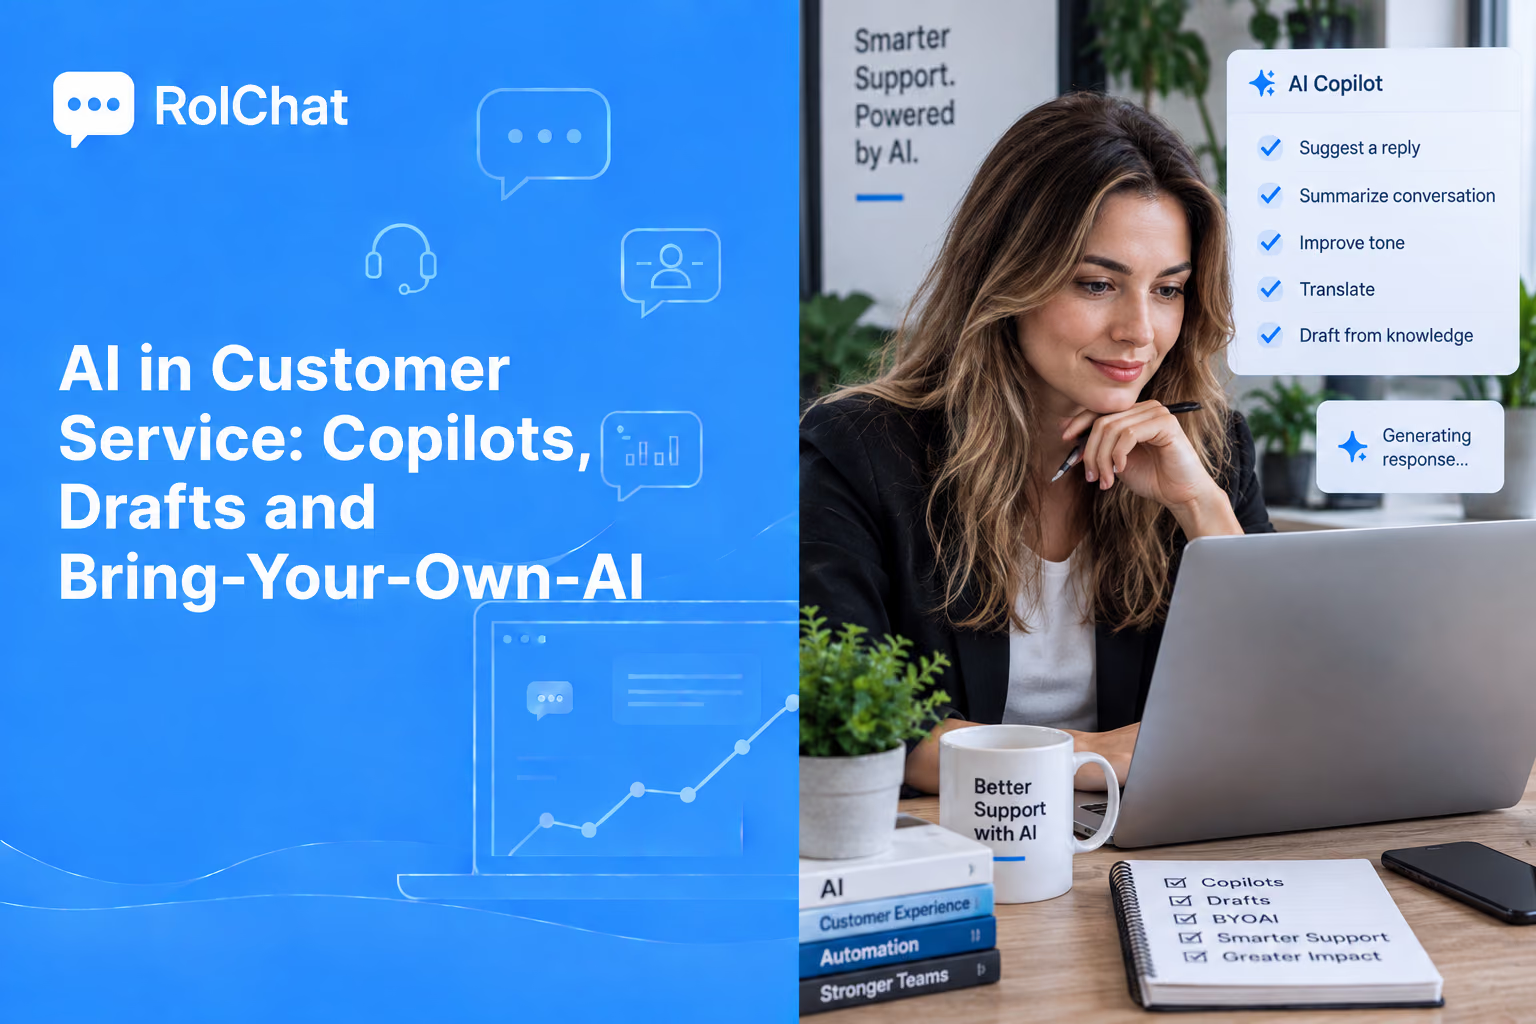
Dans le modèle du copilote, le modèle prépare, l'agent décide. Le brouillon apparaît à côté de la conversation avec ses sources jointes, et l'agent le modifie, le remplace ou l'envoie.
L'étape de relecture n'est pas une formalité. C'est le contrôle qui garde une réponse occasionnellement erronée dans votre entreprise plutôt que dans la boîte de réception de votre client.
Elle produit aussi le signal qui indique si l'automatisation fonctionne. Chaque modification est une correction étiquetée, et le taux de ces modifications est l'indicateur de qualité honnête décrit plus loin.
Où l'automatisation dépasse le champ de réponse
Traiter l'IA comme un widget greffé sur le chat en direct en gaspille l'essentiel. La même couche a du travail à accomplir dans chaque module qui touche à une conversation.
Dans la base de connaissances, elle rédige des articles à partir de fils résolus et signale les pages qui contredisent des réponses plus récentes. Un logiciel de base de connaissances de support client qui ne remarque jamais son propre vieillissement est la raison habituelle pour laquelle le libre-service cesse de dévier quoi que ce soit.
Dans le routage, elle lit l'intention avant qu'un humain ne le fasse, de sorte qu'une question de facturation atteigne la file de facturation sans passer par une étape de tri.
Dans le reporting, elle regroupe les conversations selon ce que les clients ont réellement demandé plutôt que selon l'étiquette qu'un agent a pensé à appliquer, ce qui transforme un décompte de tickets en décision produit.
Dans le travail sortant, la même classification alimente les segments de campagne, afin que les personnes qui viennent de se plaindre ne soient pas celles qui reçoivent la vente incitative.
La couverture entre modules détermine aussi la quantité de votre propre contenu que l'assistant peut atteindre. Un assistant qui ne voit que le chat en cours écrit à partir du chat en cours, et un assistant qui voit la fiche client, l'historique des commandes et les trois derniers tickets écrit à partir de tout cela.
Bring your own AI : qui détient le compte modèle
Deux questions sont fusionnées dans presque chaque démonstration. Ce que l'assistant peut faire est une question de produit. Qui détient le compte auprès du fournisseur du modèle est une question commerciale, et elle détermine si une meilleure automatisation réduit votre coût total ou l'augmente.
Lorsque la plateforme détient le compte, l'utilisation du modèle arrive comme une ligne de facturation de la plateforme, généralement sous forme de crédits ou de sièges. Le coût augmente alors avec le succès : plus l'IA gère de conversations, plus vous achetez au fournisseur, à la marge du fournisseur.
Le bring-your-own-AI inverse cela. Vous connectez vos propres clés de fournisseur, les tokens vous sont facturés directement par le fournisseur, et la plateforme ne prend aucune marge dessus. RolChat fonctionne ainsi avec 62 modèles de texte de sept fournisseurs et 23 modèles vocaux de quatre fournisseurs, soit 85 au total.
Avec une clé en bring-your-own, une amélioration qui double le volume automatisé double une facture de fournisseur que vous pouvez voir et négocier. Avec des crédits groupés, la même amélioration double une ligne sur une facture dont vous ne fixez pas le prix unitaire.
Le coût des tokens suit le contexte, pas les conversations
Les équipes nouvelles à leur propre clé s'attendent généralement à ce que la facture suive le nombre de conversations. Elle suit plutôt la longueur du contexte.
Une réponse rédigée à partir des quatre derniers messages coûte une fraction de la même réponse rédigée à partir d'un fil de soixante messages, et un résumé de ce fil entier coûte plus cher que l'un ou l'autre.
Trois paramètres font donc l'essentiel du travail : jusqu'où remonte la fenêtre de contexte, si les résumés s'exécutent sur chaque fil ou seulement sur les longs, et si la récupération puise trois articles d'aide ou trente.
Rien de tout cela n'est visible sur une page de comparaison de forfaits. C'est visible sur le tableau de bord du fournisseur dès la première semaine, ce qui est l'argument en faveur de détenir vous-même le compte.
Choisir un modèle par tâche
Un seul modèle pour chaque tâche est le choix par défaut coûteux. Le travail se divise clairement selon le degré de jugement que chaque tâche exige.
| Tâche | Ce qu'elle demande | Choix judicieux |
|---|---|---|
| Étiquetage et intention | Rapidité, faible coût, sortie stable | Un petit modèle rapide |
| Rédaction de réponse | Ton, raisonnement sur l'historique | Un modèle moyen ou grand |
| Politique et remboursements | Rigueur, formulation exacte | Le modèle le plus puissant disponible |
| Traduction | Couverture de vos langues | Le fournisseur qui les couvre le mieux |
Répartir ainsi réduit généralement la facture plus que n'importe quel réglage de prompt, car les tâches à fort volume sont les moins chères et le modèle coûteux ne s'exécute que là où il justifie son prix.
Une répartition de départ pratique : modèle rapide pour la classification et l'étiquetage, modèle moyen pour les brouillons, modèle le plus puissant réservé à l'argent et à la politique.
Les changements de routage avant même qu'un brouillon soit écrit
L'essentiel du gain visible survient avant que quiconque n'écrive un mot. La classification a lieu à l'arrivée, si bien que la conversation est déjà étiquetée, déjà dans la bonne file et déjà porteuse d'une priorité quand un agent l'ouvre.
Cela supprime l'étape de tri, celle que les équipes ajoutent quand le volume augmente et suppriment quand elles manquent de personnel pour s'en occuper.
Cela change aussi ce qu'un SLA mesure. Une horloge qui démarre quand un humain lit le message pour la première fois récompense la rapidité du tri. Une horloge qui démarre à l'arrivée récompense ce qui compte pour les clients, et la classification automatisée est ce qui rend la seconde option viable.
Le second effet concerne l'escalade. Quand l'intention et le sentiment sont attachés dès le premier message, la règle qui pousse un fil de facturation coléreux vers un agent senior peut se déclencher immédiatement plutôt qu'à la deuxième réponse.
À vérifier lors d'une démonstration : si la classification s'exécute à l'arrivée ou à la première ouverture, car seule la première option supprime l'étape de tri.
Les données que l'assistant ne doit jamais atteindre
Ancrer un assistant dans votre propre contenu implique de décider ce qui compte comme votre propre contenu. Les conversations résolues sont le matériau d'entraînement le plus utile et le plus susceptible de contenir des numéros de carte et des documents d'identité que des clients ont collés dans un chat.
Trois contrôles portent l'essentiel du poids : la rédaction (masquage) avant que quoi que ce soit n'atteigne le modèle, des limites de rétention sur les transcriptions, et une règle selon laquelle l'assistant se sert dans les articles d'aide publiés plutôt que dans les fils bruts.
Le consentement relève de la même décision. RolChat le gère comme un module payant en option à 5 $ par site, avec trois consentements par site, et il n'est pas disponible sur Lite.
Les demandes de suppression sont le cas qui piège les équipes. Un enregistrement retiré du helpdesk mais encore présent dans un index vectoriel reste un enregistrement, alors vérifiez qu'une suppression atteint bien la récupération et pas seulement la liste des tickets.
Garder des réponses justes et fidèles à la marque
Deux paramètres séparent une sortie que vous pouvez envoyer d'une sortie que vous devez réécrire.
Le premier est l'ancrage. Les réponses sont rédigées à partir de contenu approuvé : articles d'aide et conversations résolues, et le brouillon porte les sources qu'il a utilisées. Une réponse sans source derrière elle est une supposition qui porte un ton confiant.
Le second est la voix. Un réglage de ton et un glossaire des termes à utiliser ou non font que les brouillons sonnent comme votre équipe plutôt que comme un assistant générique.
Le glossaire compte davantage entre les langues. Les noms de produits et les termes juridiques sont exactement les mots qu'une couche de traduction traduira volontiers, sauf instruction contraire.
RolChat couvre 40 langues d'interface et de widget, et le même glossaire s'applique à toutes.
La voix : la même question, un délai plus serré
La voix accroît les enjeux car il n'y a pas de brouillon à relire. La réponse est prononcée au fur et à mesure qu'elle est générée, si bien que l'ancrage doit être correct à l'avance plutôt que corrigé sur le moment.
La division pratique se fait par conséquence. Transcription vocale sur chaque appel, car un transcript reste utile même imparfait. Réponses vocales automatisées uniquement là où une erreur coûte peu : horaires, statut, routage.
Les minutes d'appel sont facturées séparément du forfait chez RolChat, si bien que le volume vocal est une ligne que vous surveillez à part plutôt qu'une surprise cachée dans un prix de siège.
L'ordre de déploiement compte autant que les réglages. Les équipes qui activent tout d'un coup ne peuvent pas dire quel changement a fait bouger quel chiffre, et finissent par tout garder ou tout abandonner.
La séquence qui se lit clairement est d'abord la classification, puis les brouillons sur une file, puis les brouillons partout, puis toute gestion autonome. Chaque étape a son propre avant et après.
Mesurer si l'automatisation a fonctionné
Le taux de déviation est l'indicateur que les éditeurs mettent en avant et le moins utile, car une conversation qui se termine sans humain peut se conclure par une réponse ou par un client qui abandonne.
Quatre chiffres en disent plus. Le taux de modification des brouillons, qui baisse à mesure que l'ancrage s'améliore. Le délai de première réponse, où le copilote se rentabilise. Le taux de réouverture, qui repère les réponses qui n'avaient l'air terminées qu'en apparence. La note client répartie entre traitement automatisé et humain.
Lisez-les en regard de la facture du fournisseur pour la même période. Une qualité qui s'améliore pendant que le coût par conversation baisse est le résultat à conserver ; l'un sans l'autre ne l'est pas.
Les quatre chiffres nécessitent une mesure d'avant le déploiement. Les équipes qui sautent cette référence finissent par se demander si quelque chose a changé, sans moyen de le trancher.
Des limites à énoncer clairement
Deux limites méritent d'être énoncées clairement. Le déploiement sur site est un arrangement Enterprise, non disponible sur les forfaits inférieurs. Les modèles s'exécutant sur votre propre matériel sont prévus plutôt que disponibles, si bien qu'une exigence d'inférence locale aujourd'hui est une exigence que RolChat ne satisfait pas.
La tarification est par entreprise plutôt que par agent, de 19 $ sur Lite, avec Enterprise tarifée sur devis, et l'essai de 30 jours ouvre chaque fonctionnalité avec une carte enregistrée.
L'automatisation est aussi plus facile à juger une fois que les canaux qui la sous-tendent sont déjà réunis en un seul endroit, ce qui fait l'objet du guide complémentaire.
Questions fréquentes
Qu'automatise réellement un logiciel d'automatisation du service client ?
Résumer des fils, rédiger des réponses à partir de contenu approuvé, classifier l'intention, router, étiqueter et traduire. Dans le modèle du copilote, il prépare tout cela et un agent décide de ce qui est envoyé.
L'IA va-t-elle remplacer les agents du service client ?
Pas dans le modèle du copilote, qui est le schéma que la plupart des équipes devraient adopter. Le modèle rédige et l'agent relit et envoie. Ce qui disparaît, c'est la préparation répétitive, pas la personne responsable de la réponse.
Qu'est-ce que le bring-your-own-AI ?
Vous connectez vos propres clés de fournisseur, si bien que les tokens vous sont facturés directement par le fournisseur, sans marge de la plateforme. Cela signifie aussi que vous pouvez changer de modèle ou de fournisseur sans changer de helpdesk.
Combien coûte l'exécution de l'IA ?
Cela dépend bien plus de la longueur du contexte que du nombre de conversations. Les fils longs, les résumés sur chaque conversation, une récupération large et les résumés répétés sont les réglages qui font bouger la facture, et les trois sont à votre discrétion.
Quel modèle doit gérer quelle tâche ?
Un petit modèle rapide pour l'étiquetage et l'intention, un modèle moyen ou grand pour les brouillons, et le modèle le plus puissant disponible pour les remboursements et la formulation des politiques. Répartir par tâche fait généralement économiser plus que le réglage des prompts.
Comment empêcher l'IA d'inventer des réponses ?
Ancrez-la dans du contenu d'aide approuvé pour que chaque brouillon porte ses sources, gardez l'étape de relecture en place, et suivez le taux de modification et le taux de réouverture après le lancement plutôt que la seule déviation.
Les modèles peuvent-ils fonctionner sur nos propres serveurs ?
Le déploiement sur site est disponible sur Enterprise. Les modèles auto-hébergés sont prévus plutôt que disponibles aujourd'hui, si bien qu'une exigence stricte d'inférence locale n'est pas encore satisfaite.
L'automatisation fonctionne-t-elle dans plusieurs langues ?
Oui. Elle couvre 40 langues d'interface et de widget, avec traduction dans les deux sens. Conservez les termes de produit et juridiques dans un glossaire pour que la couche de traduction les laisse intacts.
Écrit sur les opérations de service client, le chat en direct, le support assisté par IA et les outils derrière une bonne expérience client.
LinkedIn