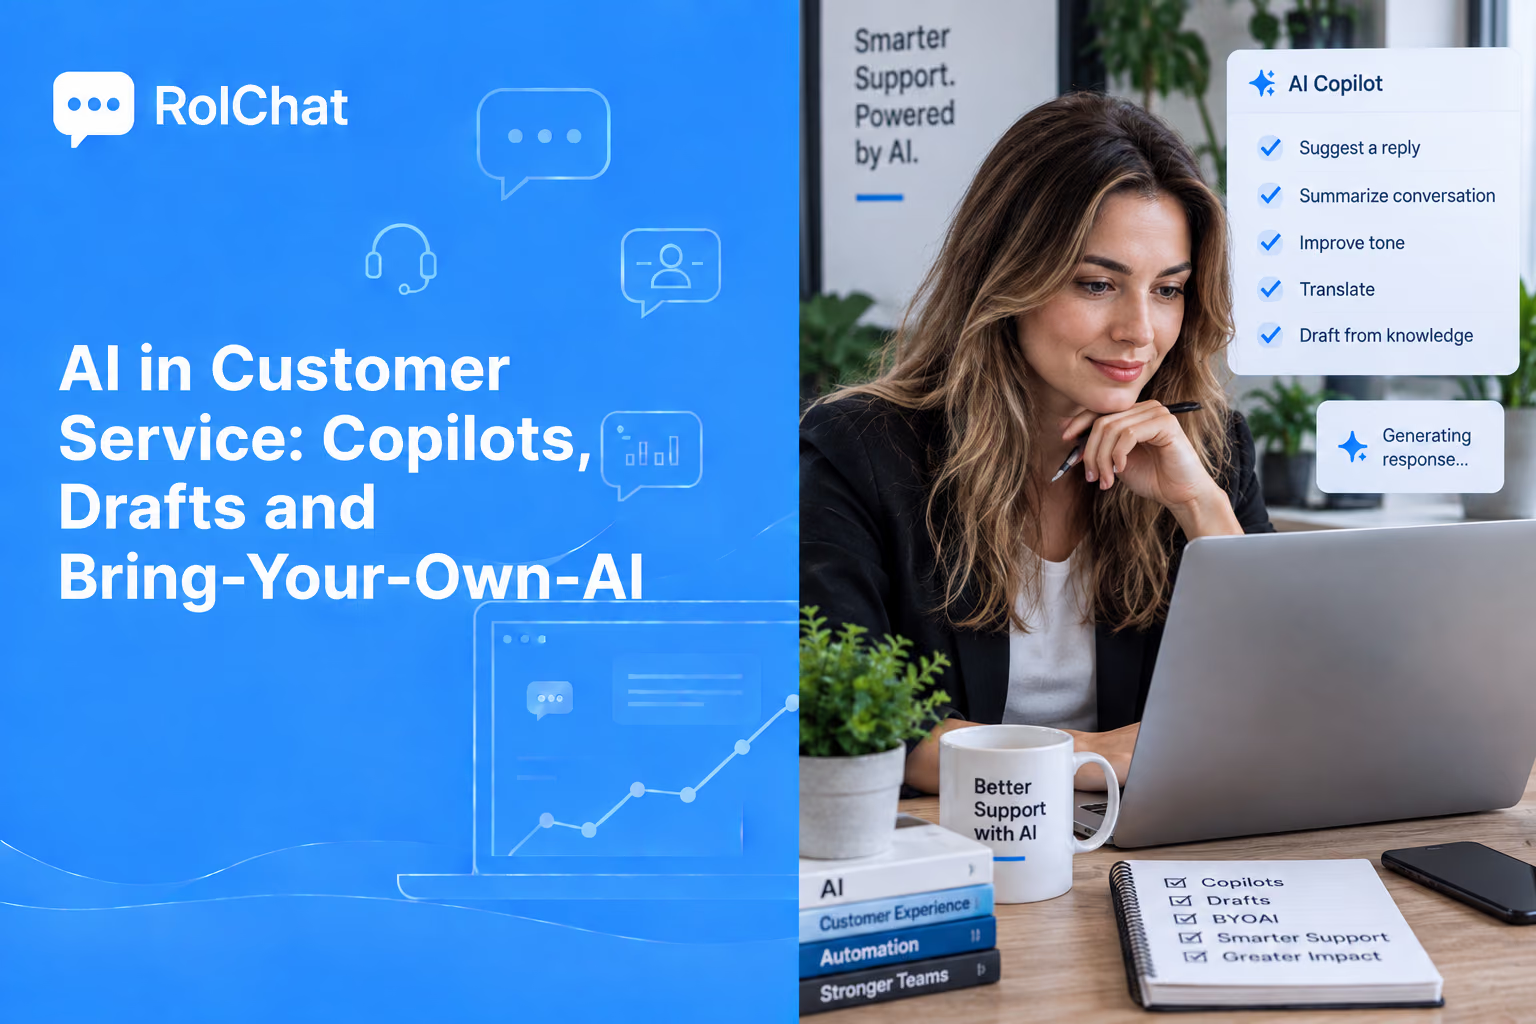
Oprogramowanie do automatyzacji obsługi klienta wyszło już poza scenariuszowego bota, który dopasowywał pytanie do drzewa decyzyjnego i poddawał się, gdy zmieniało się sformułowanie. Wersja, którą warto dziś kupić, działa obok konsultanta, czyta całą konwersację, przygotowuje szkic odpowiedzi i przekazuje go do sprawdzenia.
Ta zmiana wpływa na sposób podejmowania decyzji zakupowej. Pytanie nie brzmi już, czy narzędzie potrafi odpowiedzieć, tylko jak dużą część odpowiedzi przygotowuje samo, ile wciąż zależy od człowieka i kto płaci dostawcy modelu, gdy rośnie wolumen.
Co robi oprogramowanie do automatyzacji obsługi klienta
Za nazwą kategorii kryje się krótka lista konkretnych zadań. Podsumowanie długiej konwersacji w trzech zdaniach. Szkic odpowiedzi oparty na własnych materiałach pomocy. Klasyfikacja intencji i odpowiednie kierowanie zgłoszenia. Wykrywanie nastroju. Tłumaczenie w obie strony. Tagowanie rozmowy, aby raportowanie miało co liczyć.
Żadna z tych funkcji sama w sobie nie robi wrażenia. Każda eliminuje jedno opóźnienie lub jeden ręczny krok, a to właśnie opóźnienia odczuwają klienci.
Efekt kumulacyjny widać przy nowych pracownikach. Osoba w drugim tygodniu pracy odpowiada niemal na poziomie kogoś z drugim rokiem doświadczenia, ponieważ szkic już zawiera politykę, historię konta, właściwy ton i trzy ostatnie zamówienia.
Automatyzacja nie oznacza tu domyślnie odpowiedzi bez nadzoru. Każda z opisanych poniżej funkcji zakłada, że człowiek widzi szkic, zanim ten zostanie wysłany, a platforma jest skonfigurowana tak, by była to norma, a nie wyjątek.
Trzy poziomy automatyzacji i który wybrać
Dostawcy używają tych samych słów na opisanie bardzo różnych zachowań, dlatego warto rozdzielić poziomy według tego, kto odpowiada za wysłaną wiadomość.
| Poziom | Kto pisze | Kto wysyła | Zawodzi przez |
|---|---|---|---|
| Scenariusz | Ty, z wyprzedzeniem | System | Nierozpoznanie pytania |
| Kopilot | Model | Konsultant | Zmarnowane kliknięcie w recenzję |
| Autonomiczny agent | Model | System | Wysłanie błędnej odpowiedzi |
Scenariusze wciąż sprawdzają się przy wąskich, wysoko-wolumenowych pytaniach, których sformułowanie prawie się nie zmienia: status zamówienia, godziny otwarcia, resetowanie hasła.
Kopilot jest domyślnym wyborem dla całej reszty, ponieważ jego najgorszy scenariusz kosztuje kilka sekund, a najgorszy scenariusz autonomicznego agenta kosztuje klienta.
Najlepsze dla większości zespołów: scenariusze dla pięciu najczęstszych pytań, kopilot wszędzie indziej, autonomia tylko tam, gdzie błędna odpowiedź jest tania do odwrócenia.
Model kopilota w skrzynce odbiorczej
W modelu kopilota to model przygotowuje, a konsultant decyduje. Szkic pojawia się obok konwersacji wraz z załączonymi źródłami, a konsultant edytuje go, zastępuje lub wysyła.
Etap sprawdzania nie jest formalnością. To mechanizm kontrolny, który sprawia, że sporadyczna błędna odpowiedź pozostaje wewnątrz firmy, a nie trafia do skrzynki klienta.
Generuje też sygnał, który mówi, czy automatyzacja działa. Każda edycja to oznaczona korekta, a wskaźnik takich edycji to uczciwa miara jakości opisana dalej.
Gdzie automatyzacja sięga poza pole odpowiedzi
Traktowanie AI jak dodatku doczepionego do czatu na żywo marnuje większość jego możliwości. Ta sama warstwa ma pracę do wykonania w każdym module, który dotyczy konwersacji.
W bazie wiedzy tworzy artykuły na podstawie zamkniętych wątków i oznacza strony sprzeczne z nowszymi odpowiedziami. Oprogramowanie bazy wiedzy obsługi klienta, które nigdy nie zauważa własnej nieaktualności, to zwykle powód, dla którego samoobsługa przestaje cokolwiek odciążać.
W routingu odczytuje intencję, zanim zrobi to człowiek, dzięki czemu pytanie dotyczące rozliczeń trafia do kolejki rozliczeniowej bez przechodzenia przez etap wstępnej selekcji.
W raportowaniu grupuje konwersacje według tego, o co klienci faktycznie pytali, a nie według tagu, który konsultant pamiętał, aby zastosować - to właśnie zamienia liczbę zgłoszeń w decyzję produktową.
W działaniach wychodzących ta sama klasyfikacja napędza segmenty kampanii, dzięki czemu osoby, które właśnie się poskarżyły, nie są tymi, które otrzymują ofertę dosprzedaży.
Zasięg w modułach decyduje też o tym, jak dużą część własnych materiałów widzi asystent. Asystent, który widzi tylko bieżącą rozmowę, pisze na podstawie bieżącej rozmowy, a asystent, który widzi kartę klienta, historię zamówień i trzy ostatnie zgłoszenia, pisze na podstawie tego wszystkiego.
Bring your own AI: kto posiada konto modelu
Niemal w każdej prezentacji miesza się dwa pytania. To, co potrafi asystent, jest kwestią produktową. Kto posiada konto u dostawcy modelu, jest kwestią komercyjną i to ona decyduje, czy lepsza automatyzacja obniża, czy podnosi Twój całkowity koszt.
Gdy platforma posiada konto, zużycie modelu pojawia się jako pozycja rozliczeniowa platformy, zwykle jako kredyty lub miejsca. Koszt rośnie wtedy wraz z sukcesem: im więcej konwersacji obsługuje AI, tym więcej kupujesz od dostawcy z marżą dostawcy.
Bring-your-own-AI odwraca tę zależność. Podłączasz własne klucze dostawcy, tokeny są rozliczane bezpośrednio przez dostawcę na Twoje konto, a platforma nie nalicza na nich marży. RolChat działa w ten sposób w oparciu o 62 modele tekstowe od siedmiu dostawców i 23 modele głosowe od czterech, w sumie 85.
Przy własnym kluczu ulepszenie, które podwaja wolumen automatyzacji, podwaja rachunek u dostawcy, który widzisz i możesz negocjować. Przy pakietowych kredytach to samo ulepszenie podwaja pozycję na fakturze, której ceny jednostkowej nie ustalasz.
Koszt tokenów zależy od kontekstu, nie od liczby rozmów
Zespoły nowe we własnym kluczu zwykle oczekują, że rachunek będzie rósł wraz z liczbą rozmów. Zamiast tego rośnie wraz z długością kontekstu.
Odpowiedź opracowana na podstawie ostatnich czterech wiadomości kosztuje ułamek tego, co ta sama odpowiedź opracowana na podstawie wątku liczącego sześćdziesiąt wiadomości, a podsumowanie całego tego wątku kosztuje więcej niż jedno i drugie.
Trzy ustawienia odpowiadają więc za większość efektu: jak daleko wstecz sięga okno kontekstu, czy podsumowania działają w każdym wątku, czy tylko w długich, oraz czy wyszukiwanie pobiera trzy artykuły pomocy, czy trzydzieści.
Nic z tego nie widać na stronie porównania planów. Widać to na panelu dostawcy już w pierwszym tygodniu, co jest argumentem za posiadaniem własnego konta.
Wybór modelu do zadania
Jeden model do wszystkich zadań to kosztowna wartość domyślna. Praca dzieli się w naturalny sposób według tego, ile osądu wymaga dane zadanie.
| Zadanie | Wymaga | Rozsądny wybór |
|---|---|---|
| Tagowanie i intencja | Szybkość, niski koszt, stabilny wynik | Mały, szybki model |
| Szkicowanie odpowiedzi | Ton, wnioskowanie na podstawie historii | Model średni lub duży |
| Polityka i zwroty | Staranność, dokładne sformułowania | Najsilniejszy dostępny model |
| Tłumaczenie | Pokrycie Twoich języków | Dostawca, który obsługuje je najlepiej |
Podział w ten sposób zwykle obniża rachunek bardziej niż jakiekolwiek dopracowywanie promptów, ponieważ zadania o wysokim wolumenie są tanie, a drogi model działa tylko tam, gdzie zarabia na swoją cenę.
Praktyczny podział startowy: szybki model do klasyfikacji i tagowania, średni model do szkiców, najsilniejszy model zarezerwowany dla spraw finansowych i polityki.
Zmiany w routingu, zanim powstanie jakikolwiek szkic
Większość widocznego zysku pojawia się, zanim ktokolwiek napisze choć jedno słowo. Klasyfikacja następuje w momencie wpłynięcia zgłoszenia, więc konwersacja jest już otagowana, znajduje się we właściwej kolejce i ma już przypisany priorytet, gdy konsultant ją otwiera.
To eliminuje zmianę poświęconą wstępnej selekcji - etap, który zespoły dodają, gdy rośnie wolumen, i usuwają, gdy brakuje im do tego ludzi.
Zmienia to też, co mierzy SLA. Zegar, który startuje, gdy człowiek pierwszy raz przeczyta wiadomość, nagradza szybkość wstępnej selekcji. Zegar, który startuje w momencie wpłynięcia zgłoszenia, nagradza to, na czym zależy klientom, a automatyczna klasyfikacja jest tym, co sprawia, że ten drugi model jest wykonalny.
Drugi efekt dotyczy eskalacji. Gdy intencja i nastrój są przypisane już od pierwszej wiadomości, reguła przekazująca rozzłoszczony wątek rozliczeniowy do starszego konsultanta może zadziałać natychmiast, zamiast dopiero przy drugiej odpowiedzi.
Warto sprawdzić podczas prezentacji: czy klasyfikacja następuje w momencie wpłynięcia zgłoszenia, czy dopiero przy pierwszym otwarciu, ponieważ tylko ta pierwsza eliminuje etap wstępnej selekcji.
Dane, do których asystent nigdy nie powinien mieć dostępu
Opieranie asystenta na własnych materiałach oznacza decyzję, co liczy się jako materiał własny. Zamknięte konwersacje są najbardziej użytecznym materiałem treningowym i najbardziej prawdopodobnym miejscem, w którym znajdą się numery kart i dokumenty tożsamości, które klienci wkleili do czatu.
Trzy mechanizmy kontrolne odpowiadają za większość znaczenia: redakcja danych, zanim cokolwiek trafi do modelu, limity przechowywania transkryptów oraz reguła, że asystent pobiera dane z opublikowanych artykułów pomocy, a nie z surowych wątków.
Zgoda należy do tej samej decyzji. RolChat obsługuje ją jako płatny dodatek za 5 USD za witrynę, z trzema zgodami na witrynę, i nie jest on dostępny w planie Lite.
Żądania usunięcia danych to przypadek, który zaskakuje zespoły. Rekord usunięty z helpdesku, ale wciąż znajdujący się w indeksie wektorowym, wciąż jest rekordem, dlatego warto sprawdzić, czy usunięcie obejmuje wyszukiwanie, a nie tylko listę zgłoszeń.
Jak dbać o dokładność odpowiedzi i zgodność z marką
Dwa ustawienia oddzielają treść, którą można wysłać, od treści, którą trzeba przepisać.
Pierwszym jest uziemienie w materiałach źródłowych. Odpowiedzi są tworzone na podstawie zatwierdzonych materiałów: artykułów pomocy i zamkniętych konwersacji, a szkic zawiera źródła, z których korzystał. Odpowiedź bez żadnego źródła to zgadywanie w przebraniu pewności siebie.
Drugim jest głos marki. Ustawienie tonu oraz słownik terminów, których się używa i których nie, sprawiają, że szkice brzmią jak Twój zespół, a nie jak ogólny asystent.
Słownik ma jeszcze większe znaczenie przy wielu językach. Nazwy produktów i terminy prawne to dokładnie te słowa, które warstwa tłumaczenia chętnie przetłumaczy, jeśli nie zostanie poinstruowana inaczej.
RolChat obsługuje 40 języków interfejsu i widgetu, a ten sam słownik dotyczy ich wszystkich.
Głos: to samo pytanie, trudniejszy termin
Głos podnosi stawkę, ponieważ nie ma szkicu do sprawdzenia. Odpowiedź jest wypowiadana w miarę generowania, więc uziemienie w materiałach musi być poprawne z wyprzedzeniem, a nie korygowane na bieżąco.
Praktyczny podział przebiega według konsekwencji. Zamiana mowy na tekst przy każdym połączeniu, ponieważ transkrypcja jest użyteczna nawet wtedy, gdy jest niedoskonała. Wypowiadane automatyczne odpowiedzi tylko tam, gdzie błąd jest tani: godziny otwarcia, status, kierowanie zgłoszeń.
Minuty połączeń są w RolChat rozliczane osobno od planu, więc wolumen głosowy to pozycja, którą obserwujesz samodzielnie, a nie niespodzianka ukryta w cenie miejsca.
Kolejność wdrażania ma równie duże znaczenie co same ustawienia. Zespoły, które włączają wszystko naraz, nie potrafią stwierdzić, która zmiana wpłynęła na którą liczbę, i kończą albo zatrzymując wszystko, albo rezygnując ze wszystkiego.
Kolejność, która daje przejrzysty obraz, to najpierw klasyfikacja, potem szkice w jednej kolejce, potem szkice wszędzie, a na końcu ewentualna obsługa autonomiczna. Każdy krok ma swoje własne przed i po.
Mierzenie skuteczności automatyzacji
Wskaźnik odciążenia (deflection rate) to metryka, którą dostawcy chętnie eksponują, i najmniej użyteczna z nich, ponieważ konwersacja, która kończy się bez udziału człowieka, może zakończyć się odpowiedzią albo rezygnacją klienta.
Więcej mówią cztery liczby. Wskaźnik edycji szkiców, który spada w miarę poprawy uziemienia w materiałach. Czas pierwszej odpowiedzi, gdzie kopilot zwraca się z inwestycji. Wskaźnik ponownego otwarcia, który wychwytuje odpowiedzi, które tylko wyglądały na zakończone. Ocena klienta w podziale na obsługę automatyczną i ludzką.
Odczytuj je razem z rachunkiem od dostawcy za ten sam okres. Jakość, która rośnie przy jednoczesnym spadku kosztu na konwersację, to wynik wart utrzymania; żadne z nich osobno nie wystarczy.
Wszystkie cztery liczby wymagają odczytu sprzed wdrożenia. Zespoły, które pomijają punkt odniesienia, kończą na sporze o to, czy cokolwiek się zmieniło, bez możliwości jego rozstrzygnięcia.
Ograniczenia, o których warto powiedzieć wprost
Warto wprost powiedzieć o dwóch ograniczeniach. Wdrożenie on-premise jest rozwiązaniem dostępnym w ramach planu Enterprise, a nie na niższych planach. Modele działające na własnym sprzęcie są planowane, a nie dostępne, więc wymóg lokalnego wnioskowania jest dziś wymogiem, którego RolChat nie spełnia.
Cennik jest ustalany za firmę, a nie za konsultanta, od 19 USD w planie Lite, natomiast cena planu Enterprise ustalana jest indywidualnie, a 30-dniowy okres próbny otwiera każdą funkcję po podaniu karty.
Automatyzację łatwiej też ocenić, gdy kanały, na których działa, są już zebrane w jednym miejscu - to temat towarzyszącego przewodnika.
Najczęściej zadawane pytania
Co dokładnie automatyzuje oprogramowanie do automatyzacji obsługi klienta?
Podsumowywanie wątków, szkicowanie odpowiedzi na podstawie zatwierdzonych materiałów, klasyfikację intencji, routing, tagowanie i tłumaczenie. W modelu kopilota przygotowuje to wszystko, a konsultant decyduje, co zostaje wysłane.
Czy AI zastąpi konsultantów obsługi klienta?
Nie w modelu kopilota, który jest wzorcem, jaki powinna stosować większość zespołów. Model przygotowuje szkic, a konsultant go sprawdza i wysyła. Znika powtarzalne przygotowywanie, a nie osoba odpowiedzialna za odpowiedź.
Czym jest bring-your-own-AI?
Podłączasz własne klucze dostawcy, dzięki czemu tokeny są rozliczane bezpośrednio przez dostawcę bez marży platformy. Oznacza to też, że możesz zmienić model lub dostawcę bez zmiany helpdesku.
Ile kosztuje działanie AI?
Zależy to znacznie bardziej od długości kontekstu niż od liczby konwersacji. Długie wątki, podsumowania w każdej konwersacji, szerokie wyszukiwanie i wielokrotne ponowne podsumowywanie to ustawienia, które wpływają na rachunek, a wszystkie trzy ustalasz sam.
Który model powinien obsługiwać które zadanie?
Mały, szybki model do tagowania i intencji, model średni lub duży do szkiców oraz najsilniejszy dostępny model do zwrotów i sformułowań polityki. Podział według zadań zwykle oszczędza więcej niż dopracowywanie promptów.
Jak zapobiegać zmyślaniu odpowiedzi przez AI?
Oprzyj go na zatwierdzonych materiałach pomocy, aby każdy szkic zawierał swoje źródła, utrzymuj etap sprawdzania i śledź wskaźnik edycji oraz wskaźnik ponownego otwarcia po wdrożeniu, a nie tylko wskaźnik odciążenia.
Czy modele mogą działać na naszych własnych serwerach?
Wdrożenie on-premise jest dostępne w planie Enterprise. Modele hostowane samodzielnie są planowane, a nie dostępne dziś, więc bezwzględny wymóg lokalnego wnioskowania nie jest jeszcze spełniony.
Czy automatyzacja działa w wielu językach?
Tak. Obejmuje 40 języków interfejsu i widgetu, z tłumaczeniem w obie strony. Trzymaj nazwy produktów i terminy prawne w słowniku, aby warstwa tłumaczenia ich nie ruszała.
Pisze o obsłudze klienta, czacie na żywo, wsparciu z pomocą AI i narzędziach stojących za dobrym doświadczeniem klienta.
LinkedIn