Software voor klantenservice-automatisering is verder gegaan dan de bot met vaste scripts die een vraag vergeleek met een beslisboom en het opgaf zodra de formulering veranderde. De versie die het nu waard is om aan te schaffen, zit naast de medewerker, leest de hele thread, stelt een antwoord op en geeft dit door ter beoordeling.
Die verschuiving verandert de aankoopvraag. Het gaat niet langer om of de tool kan antwoorden, maar om hoeveel van het antwoord het voorbereidt, hoeveel een mens nog steeds beheert, en wie de modelaanbieder betaalt als het volume groeit.
Wat software voor klantenservice-automatisering doet
Achter de categorienaam schuilt een korte lijst met concrete taken. Vat een lange thread samen in drie regels. Stel een antwoord op dat gebaseerd is op je eigen helpinhoud. Classificeer intentie en route dienovereenkomstig. Detecteer sentiment. Vertaal in beide richtingen. Tag het gesprek zodat rapportage iets heeft om te tellen.
Geen van die dingen is op zich spectaculair. Elk elimineert een vertraging of een handmatige stap, en die vertragingen zijn wat klanten voelen.
Het cumulatieve effect blijkt bij nieuwe medewerkers. Iemand in zijn tweede week antwoordt bijna op het niveau van iemand in zijn tweede jaar, omdat het concept al het beleid, de accountgeschiedenis, de juiste toon en de laatste drie bestellingen bevat.
Automatisering betekent hier niet standaard onbeheerde antwoorden. Elke onderstaande mogelijkheid gaat ervan uit dat een mens het concept kan zien voordat het wordt verzonden, en het platform is zo geconfigureerd dat dit het normale pad is en niet de uitzondering.
Drie niveaus van automatisering, en welke je moet kiezen
Leveranciers gebruiken dezelfde woorden voor heel verschillend gedrag, dus het helpt om de niveaus te scheiden op basis van wie verantwoordelijk is voor het verzonden bericht.
| Niveau | Wie schrijft | Wie verstuurt | Faalt door |
|---|---|---|---|
| Scriptflow | U, vooraf | Het systeem | De vraag niet herkennen |
| Copilot | Het model | De medewerker | Een beoordelingsklik verspillen |
| Autonome agent | Het model | Het systeem | Een verkeerd antwoord versturen |
Scriptflows verdienen nog steeds hun plaats bij de smalle, veelvoorkomende vragen waarbij de formulering nauwelijks varieert: bestelstatus, openingstijden, wachtwoordresets.
De copilot is de standaard voor al het andere, omdat het slechtste resultaat een paar seconden kost, terwijl het slechtste resultaat van de autonome agent een klant kost.
Het beste voor de meeste teams: scriptflows voor de top vijf terugkerende vragen, copilot voor de rest, autonoom alleen waar een verkeerd antwoord goedkoop is om terug te draaien.
Het copilotmodel in de inbox
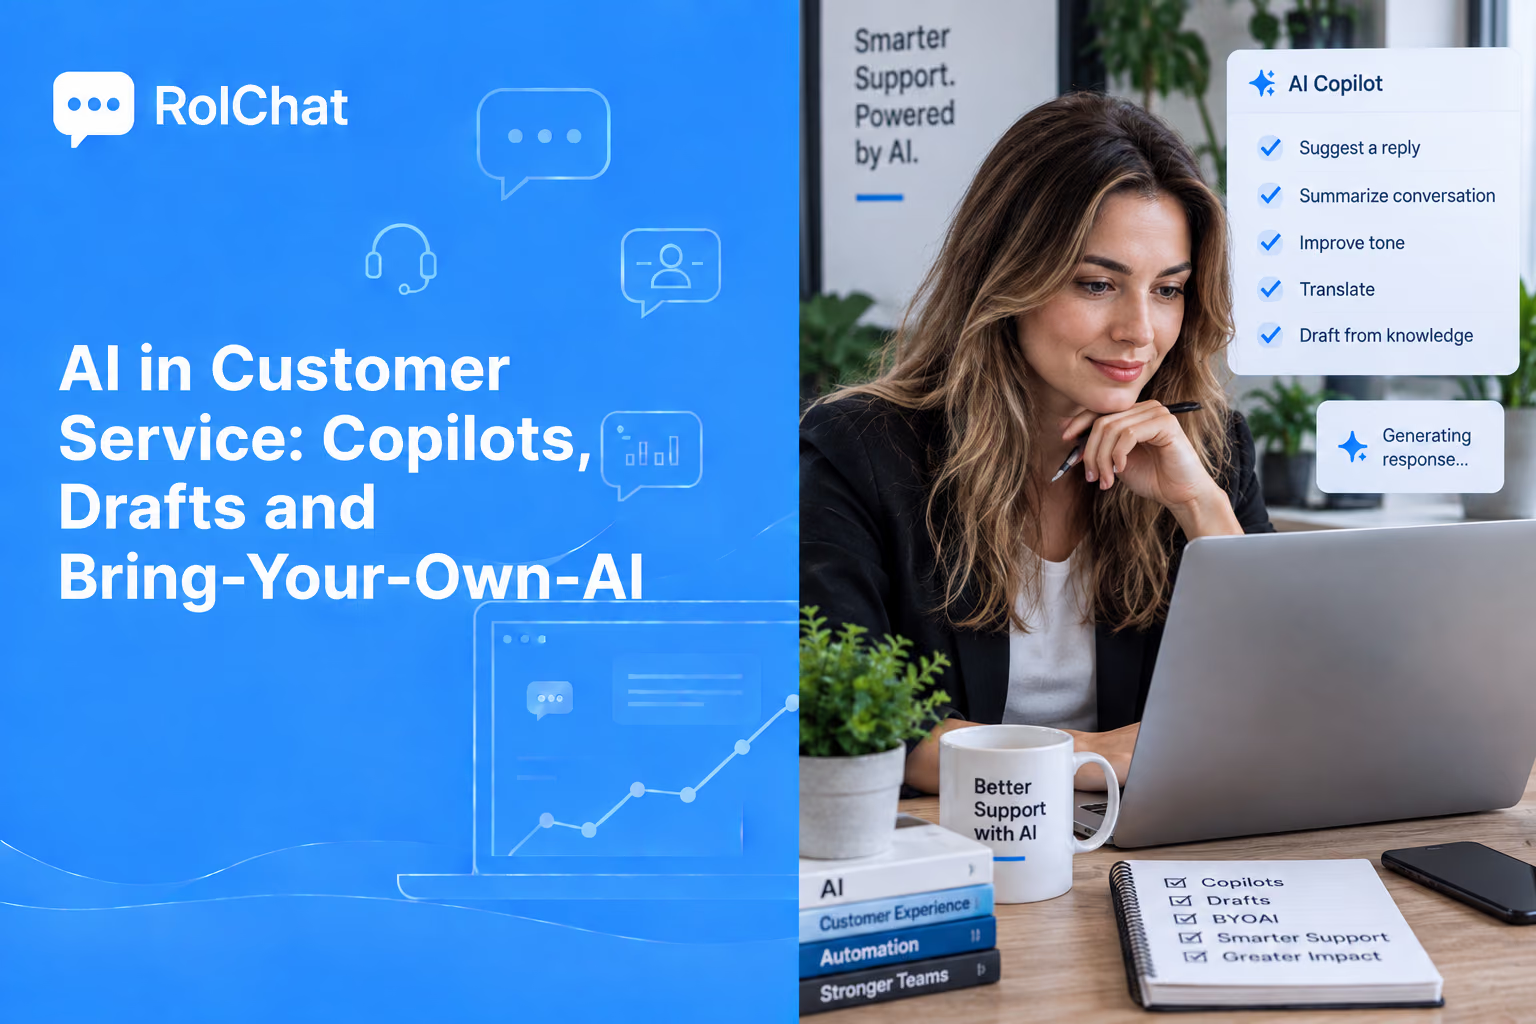
Bij het copilotpatroon bereidt het model voor, en beslist de medewerker. Het concept verschijnt naast het gesprek met de bijbehorende bronnen, en de medewerker bewerkt, vervangt of verstuurt het.
De beoordelingsstap is geen formaliteit. Het is de controle die een af en toe verkeerd antwoord binnen uw organisatie houdt in plaats van in de mailbox van uw klant.
Het levert ook het signaal op dat aangeeft of de automatisering werkt. Elke bewerking is een gelabelde correctie, en de frequentie van die bewerkingen is de eerlijke kwaliteitsmeting die verderop wordt beschreven.
Waar automatisering verder reikt dan het antwoordvak
AI behandelen als een widget die aan livechat is vastgeplakt, verspilt het grootste deel ervan. Dezelfde laag heeft werk te doen in elke module die een gesprek raakt.
In de kennisbank stelt het artikelen op basis van opgeloste threads en markeert het pagina's die nieuwere antwoorden tegenspreken. Software voor klantenservice-kennisbanken die nooit merkt dat zij zelf verouderd raakt, is meestal de reden waarom self-service stopt met het afbuigen van iets.
Bij routering leest het de intentie voordat een mens dat doet, zodat een factuurvraag de factureringswachtrij bereikt zonder eerst door een triagestap te gaan.
Bij rapportage groepeert het gesprekken op basis van wat klanten daadwerkelijk vroegen in plaats van op de tag die een medewerker toevallig toepaste, en dat is wat een ticketaantal omzet in een productbeslissing.
Bij uitgaand werk stuurt dezelfde classificatie campagnesegmenten aan, zodat de mensen die net hebben geklaagd niet de mensen zijn die de upsell krijgen.
Dekking over modules bepaalt ook hoeveel van uw eigen materiaal de assistent kan bereiken. Een assistent die alleen de huidige chat ziet, schrijft vanuit de huidige chat, en een assistent die het klantdossier, de bestelgeschiedenis en de laatste drie tickets ziet, schrijft vanuit dat alles.
Bring your own AI: wie beheert het modelaccount
Twee vragen worden in bijna elke demo door elkaar gehaald. Wat de assistent kan doen is een productvraag. Wie het account bij de modelaanbieder beheert, is een commerciële vraag, en die bepaalt of betere automatisering uw totale kosten verlaagt of verhoogt.
Wanneer het platform het account beheert, komt modelgebruik binnen als een platformregel, meestal als credits of licenties. De kosten stijgen dan met het succes: hoe meer gesprekken de AI afhandelt, hoe meer u koopt van de leverancier tegen de marge van de leverancier.
Bring-your-own-AI keert dit om. U verbindt uw eigen aanbiedersleutels, tokens worden rechtstreeks door de aanbieder aan u gefactureerd, en het platform rekent geen opslag erop. RolChat werkt op deze manier met 62 tekstmodellen van zeven aanbieders en 23 spraakmodellen van vier, 85 in totaal.
Met een eigen sleutel verdubbelt een verbetering die het geautomatiseerde volume verdubbelt een rekening van de aanbieder die u kunt zien en onderhandelen. Bij gebundelde credits verdubbelt diezelfde verbetering een regel op een factuur waarvan u de eenheidsprijs niet bepaalt.
Tokenkosten volgen context, niet gesprekken
Teams die nieuw zijn met hun eigen sleutel verwachten meestal dat de rekening het aantal gesprekken volgt. In plaats daarvan volgt deze de contextlengte.
Een antwoord opgesteld op basis van de laatste vier berichten kost een fractie van hetzelfde antwoord opgesteld op basis van een thread van zestig, en een samenvatting van die hele thread kost meer dan beide.
Drie instellingen doen daarom het meeste werk: hoe ver het contextvenster teruggaat, of samenvattingen op elke thread worden uitgevoerd of alleen op lange, en of retrieval drie helpartikelen ophaalt of dertig.
Niets daarvan is zichtbaar op een pagina met abonnementsvergelijking. Het is wel zichtbaar op het dashboard van de aanbieder in de eerste week, wat het argument is om het account zelf te beheren.
Een model per taak kiezen
Eén model voor elke taak is de dure standaardoptie. Het werk splitst zich netjes op basis van hoeveel beoordelingsvermogen elke taak vereist.
| Taak | Vereist | Verstandige keuze |
|---|---|---|
| Taggen en intentie | Snelheid, lage kosten, stabiele output | Een klein, snel model |
| Concepten opstellen | Toon, redeneren over geschiedenis | Een middelgroot of groot model |
| Beleid en terugbetalingen | Zorgvuldigheid, exacte formulering | Het sterkste beschikbare model |
| Vertaling | Dekking van uw talen | Welke aanbieder deze het beste dekt |
Op deze manier splitsen verlaagt de rekening meestal meer dan promptafstemming, omdat de taken met hoog volume de goedkope zijn en het dure model alleen draait waar het zijn prijs waard is.
Een praktische startverdeling: snel model voor classificatie en taggen, middelgroot model voor concepten, sterkste model gereserveerd voor geld en beleid.
Routeringswijzigingen voordat er een concept is geschreven
Het grootste deel van de zichtbare winst ontstaat voordat iemand een woord schrijft. Classificatie gebeurt bij binnenkomst, zodat het gesprek al is getagd, al in de juiste wachtrij staat en al een prioriteit heeft wanneer een medewerker het opent.
Dat elimineert de triagedienst, wat de stap is die teams toevoegen wanneer het volume groeit en verwijderen wanneer ze geen mensen meer hebben om dit te doen.
Het verandert ook wat een SLA meet. Een klok die start wanneer een mens het bericht voor het eerst leest, beloont triagesnelheid. Een klok die start bij binnenkomst, beloont wat klanten belangrijk vinden, en geautomatiseerde classificatie is wat de tweede optie haalbaar maakt.
Het tweede effect betreft escalatie. Wanneer intentie en sentiment vanaf het eerste bericht zijn gekoppeld, kan de regel die een boze factureringsthread naar een senior medewerker doorstuurt, onmiddellijk in werking treden in plaats van bij het tweede antwoord.
De moeite waard om in een demo te controleren: of classificatie plaatsvindt bij binnenkomst of bij het eerste openen, want alleen de eerste optie elimineert de triagestap.
Gegevens die de assistent nooit mag bereiken
Een assistent baseren op uw eigen inhoud betekent bepalen wat als uw eigen inhoud geldt. Opgeloste gesprekken zijn het nuttigste trainingsmateriaal en bevatten het meest waarschijnlijk kaartnummers en identiteitsdocumenten die klanten in een chat hebben geplakt.
Drie controles dragen het grootste deel van het gewicht: redactie voordat iets het model bereikt, bewaartermijnen voor transcripten, en een regel dat de assistent gegevens ophaalt uit gepubliceerde helpartikelen in plaats van uit ruwe threads.
Toestemming hoort bij dezelfde beslissing. RolChat behandelt dit als een betaalde add-on voor $5 per site, met drie toestemmingen per site, en dit is niet beschikbaar in Lite.
Verwijderingsverzoeken zijn het geval dat teams overvalt. Een record dat is verwijderd uit de helpdesk maar nog steeds in een vector-index staat, is nog steeds een record, dus controleer of een verwijdering ook de retrieval bereikt en niet alleen de ticketlijst.
Antwoorden accuraat en on-brand houden
Twee instellingen scheiden output die u kunt versturen van output die u opnieuw moet schrijven.
De eerste is verankering (grounding). Antwoorden worden opgesteld op basis van goedgekeurd materiaal: helpartikelen en opgeloste gesprekken, en het concept bevat de bronnen die het heeft gebruikt. Een antwoord zonder bron erachter is een gok met een zelfverzekerde toon.
De tweede is de tone-of-voice. Een toon-instelling en een woordenlijst met termen die u wel en niet gebruikt, zorgen ervoor dat concepten klinken als uw team en niet als een generieke assistent.
De woordenlijst is nog belangrijker bij meerdere talen. Productnamen en juridische termen zijn precies de woorden die een vertaallaag behulpzaam zal vertalen, tenzij anders aangegeven.
RolChat dekt 40 interface- en widgettalen, en dezelfde woordenlijst geldt voor allemaal.
Spraak: dezelfde vraag, een strakkere deadline
Spraak verhoogt de inzet omdat er geen concept is om te beoordelen. Het antwoord wordt uitgesproken zodra het wordt gegenereerd, dus de verankering moet vooraf correct zijn in plaats van op het moment zelf gecorrigeerd.
De praktische verdeling verloopt op basis van gevolgen. Spraak-naar-tekst bij elk gesprek, omdat een transcript nuttig is, zelfs als het onvolmaakt is. Gesproken geautomatiseerde antwoorden alleen waar fouten goedkoop zijn: openingstijden, status, routering.
Belminuten worden in RolChat afzonderlijk van het abonnement gefactureerd, dus spraakvolume is een post die u apart in de gaten houdt in plaats van een verrassing binnen een licentieprijs.
De volgorde van uitrol is net zo belangrijk als de instellingen. Teams die alles tegelijk inschakelen, kunnen niet zien welke wijziging welk cijfer heeft veranderd, en houden uiteindelijk alles of niets ervan.
De volgorde die logisch aanvoelt is eerst classificatie, dan concepten voor één wachtrij, dan concepten overal, dan eventuele autonome afhandeling. Elke stap heeft zijn eigen voor en na.
Meten of de automatisering werkte
Afbuigingspercentage is de meting waarmee leveranciers vooropgaan en de minst nuttige, omdat een gesprek dat zonder mens eindigt, kan eindigen in een antwoord of in een klant die het opgeeft.
Vier cijfers zeggen meer. Bewerkingspercentage van concepten, dat daalt naarmate de verankering verbetert. Eerste reactietijd, waar de copilot zichzelf terugverdient. Heropeningspercentage, dat antwoorden vangt die alleen leken afgerond te zijn. Klantbeoordeling, opgesplitst naar geautomatiseerde en menselijke afhandeling.
Lees ze naast de rekening van de aanbieder over dezelfde periode. Kwaliteit die verbetert terwijl de kosten per gesprek dalen, is het resultaat dat het waard is om te behouden; elk van beide afzonderlijk niet.
Alle vier cijfers hebben een meting nodig van vóór de uitrol. Teams die de basislijn overslaan, eindigen in discussies over of er iets veranderd is, zonder manier om dit te beslechten.
Beperkingen die het waard zijn om duidelijk te vermelden
Twee beperkingen zijn het waard om duidelijk te vermelden. On-premise implementatie is een Enterprise-regeling, niet iets dat beschikbaar is op de lagere abonnementen. Modellen die op uw eigen hardware draaien, staan gepland maar zijn nog niet beschikbaar, dus een vereiste voor lokale inferentie is vandaag een vereiste waaraan RolChat niet voldoet.
Prijzen zijn per bedrijf in plaats van per medewerker, van $19 bij Lite tot een prijs op aanvraag bij Enterprise, en de proefperiode van 30 dagen opent elke functie met een kaart op het bestand.
Automatisering is ook eenvoudiger te beoordelen zodra de kanalen erachter al op één plek staan, wat het onderwerp is van de bijbehorende gids.
Veelgestelde vragen
Wat automatiseert software voor klantenservice-automatisering eigenlijk?
Het samenvatten van threads, het opstellen van antwoorden op basis van goedgekeurde inhoud, het classificeren van intentie, routering, taggen en vertalen. Bij het copilotpatroon bereidt het dit allemaal voor en beslist een medewerker wat wordt verzonden.
Zal AI klantenservicemedewerkers vervangen?
Niet in het copilotmodel, wat het patroon is dat de meeste teams zouden moeten hanteren. Het model stelt op en de medewerker beoordeelt en verstuurt. Wat verdwijnt is repetitieve voorbereiding, niet de persoon die verantwoordelijk is voor het antwoord.
Wat is bring-your-own-AI?
U verbindt uw eigen aanbiedersleutels, zodat tokens rechtstreeks door de aanbieder aan u worden gefactureerd zonder platformopslag. Het betekent ook dat u van model of aanbieder kunt wisselen zonder van helpdesk te veranderen.
Hoeveel kost het om de AI te draaien?
Het hangt veel meer af van de contextlengte dan van het aantal gesprekken. Lange threads, samenvattingen bij elk gesprek, brede retrieval en herhaalde her-samenvatting zijn de instellingen die de rekening beïnvloeden, en alle drie kunt u zelf instellen.
Welk model moet welke taak afhandelen?
Een klein, snel model voor taggen en intentie, een middelgroot of groot model voor concepten, en het sterkste beschikbare model voor terugbetalingen en beleidsformuleringen. Splitsen per taak bespaart meestal meer dan promptafstemming.
Hoe voorkomt u dat de AI antwoorden verzint?
Verankeren in goedgekeurde helpinhoud zodat elk concept zijn bronnen bevat, de beoordelingsstap behouden, en na de lancering het bewerkingspercentage en heropeningspercentage volgen in plaats van alleen afbuiging.
Kunnen de modellen op onze eigen servers draaien?
On-premise implementatie is beschikbaar bij Enterprise. Zelf-gehoste modellen staan gepland maar zijn vandaag nog niet beschikbaar, dus aan een harde vereiste voor lokale inferentie wordt nog niet voldaan.
Werkt automatisering in meerdere talen?
Ja. Het dekt 40 interface- en widgettalen, met vertaling in beide richtingen. Houd product- en juridische termen in een woordenlijst zodat de vertaallaag deze met rust laat.
Schrijft over klantenserviceprocessen, livechat, AI-ondersteunde service en de tools achter een goede klantervaring.
LinkedIn