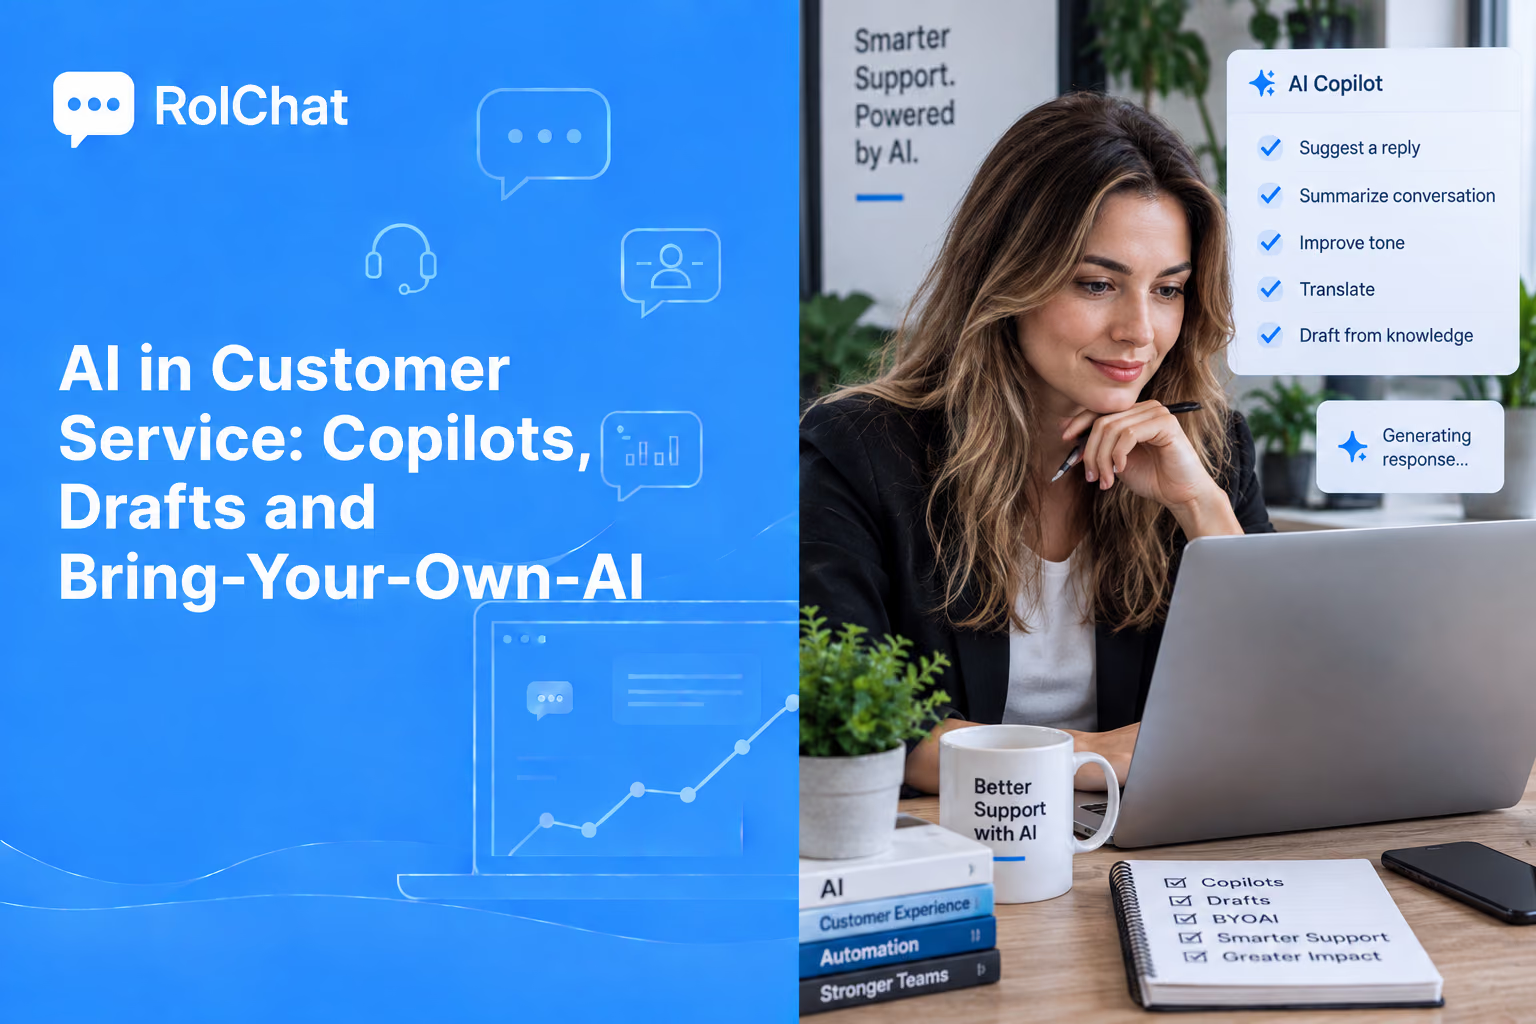
Software für Kundenservice-Automatisierung hat sich vom skriptbasierten Bot weiterentwickelt, der eine Frage mit einem Entscheidungsbaum abglich und aufgab, sobald sich die Formulierung änderte. Die Version, die sich heute zu kaufen lohnt, sitzt neben dem Mitarbeiter, liest den gesamten Thread, entwirft eine Antwort und übergibt sie zur Prüfung.
Dieser Wandel verändert die Kaufentscheidung. Es geht nicht mehr darum, ob das Tool antworten kann, sondern wie viel der Antwort es vorbereitet, wie viel weiterhin eine Person verantwortet und wer den Modellanbieter bezahlt, wenn das Volumen wächst.
Was Software für Kundenservice-Automatisierung leistet
Hinter dem Kategorienamen steckt eine kurze Liste konkreter Aufgaben. Einen langen Thread in drei Zeilen zusammenfassen. Eine Antwort entwerfen, die auf den eigenen Hilfeinhalten basiert. Absicht klassifizieren und entsprechend weiterleiten. Stimmung erkennen. In beide Richtungen übersetzen. Das Gespräch taggen, damit das Reporting etwas zu zählen hat.
Für sich genommen ist keine dieser Aufgaben spektakulär. Jede beseitigt eine Verzögerung oder einen manuellen Schritt, und genau diese Verzögerungen spüren die Kunden.
Der kumulative Effekt zeigt sich bei neuen Mitarbeitern. Eine Person in ihrer zweiten Woche antwortet nahezu auf dem Niveau von jemandem im zweiten Jahr, weil der Entwurf bereits die Richtlinie, die Kontohistorie, den richtigen Ton und die letzten drei Bestellungen enthält.
Automatisierung bedeutet hier nicht standardmäßig unbeaufsichtigte Antworten. Jede Funktion unten setzt voraus, dass eine Person den Entwurf sehen kann, bevor er verschickt wird, und die Plattform ist so konfiguriert, dass dies der normale Weg ist, nicht die Ausnahme.
Drei Automatisierungsstufen und welche man kaufen sollte
Anbieter verwenden dieselben Begriffe für sehr unterschiedliches Verhalten, daher hilft es, die Stufen danach zu unterscheiden, wer für die gesendete Nachricht verantwortlich ist.
| Stufe | Wer schreibt | Wer sendet | Scheitert an |
|---|---|---|---|
| Skriptbasierter Ablauf | Sie, im Voraus | Das System | Die Frage nicht erkennen |
| Copilot | Das Modell | Der Mitarbeiter | Einen Prüfklick verschwenden |
| Autonomer Agent | Das Modell | Das System | Eine falsche Antwort senden |
Skriptbasierte Abläufe haben nach wie vor ihre Berechtigung bei den eng umrissenen, hochvolumigen Fragen, deren Formulierung kaum variiert: Bestellstatus, Öffnungszeiten, Passwort-Zurücksetzungen.
Der Copilot ist die Standardlösung für alles Übrige, denn sein schlimmstes Ergebnis kostet ein paar Sekunden, während das schlimmste Ergebnis des autonomen Agenten einen Kunden kostet.
Am besten für die meisten Teams: skriptbasierte Abläufe für die fünf häufigsten Fragen, überall sonst Copilot, autonom nur dort, wo eine falsche Antwort günstig zu korrigieren ist.
Das Copilot-Modell im Posteingang
Im Copilot-Muster bereitet das Modell vor, der Mitarbeiter entscheidet. Der Entwurf erscheint neben dem Gespräch samt seiner Quellen, und der Mitarbeiter bearbeitet, ersetzt oder sendet ihn.
Der Prüfschritt ist keine Formsache. Er ist die Kontrolle, die eine gelegentlich falsche Antwort im eigenen Haus hält statt im Postfach des Kunden.
Er liefert außerdem das Signal, das zeigt, ob die Automatisierung funktioniert. Jede Bearbeitung ist eine gekennzeichnete Korrektur, und die Rate dieser Bearbeitungen ist die ehrliche Qualitätskennzahl, die weiter unten beschrieben wird.
Wo Automatisierung über das Antwortfeld hinausgeht
KI als bloßes Zusatzmodul für den Live-Chat zu behandeln, verschenkt das meiste Potenzial. Dieselbe Ebene hat in jedem Modul, das mit einem Gespräch in Berührung kommt, Arbeit zu leisten.
In der Wissensdatenbank entwirft sie Artikel aus gelösten Threads und markiert Seiten, die neueren Antworten widersprechen. Software für Kundenservice-Wissensdatenbanken, die die eigene Veralterung nie bemerkt, ist meist der Grund, warum die Selbstbedienung nichts mehr abfängt.
Beim Routing liest sie die Absicht, bevor ein Mensch das tut, sodass eine Abrechnungsfrage die Abrechnungswarteschlange erreicht, ohne einen Triage-Schritt zu durchlaufen.
Beim Reporting gruppiert sie Gespräche danach, wonach Kunden tatsächlich gefragt haben, statt nach dem Tag, an das sich ein Mitarbeiter erinnert hat - genau das macht aus einer Ticketzahl eine Produktentscheidung.
Bei ausgehenden Aktivitäten steuert dieselbe Klassifizierung die Kampagnensegmente, sodass Kunden, die sich gerade beschwert haben, nicht dieselben sind, die ein Upsell-Angebot erhalten.
Die Abdeckung über mehrere Module hinweg entscheidet auch, wie viel des eigenen Materials der Assistent erreichen kann. Ein Assistent, der nur den aktuellen Chat sieht, schreibt aus dem aktuellen Chat, und ein Assistent, der den Kundendatensatz, die Bestellhistorie und die letzten drei Tickets sieht, schreibt aus all dem.
Bring your own AI: Wer verwaltet das Modellkonto
Zwei Fragen werden in fast jeder Demo vermischt. Was der Assistent leisten kann, ist eine Produktfrage. Wer das Konto beim Modellanbieter verwaltet, ist eine kommerzielle Frage, und sie entscheidet, ob bessere Automatisierung Ihre Gesamtkosten senkt oder erhöht.
Wenn die Plattform das Konto verwaltet, taucht die Modellnutzung als Plattform-Posten auf, meist als Guthaben oder Sitzplätze. Die Kosten steigen dann mit dem Erfolg: Je mehr Gespräche die KI übernimmt, desto mehr kaufen Sie beim Anbieter zu dessen Marge.
Bring-your-own-AI kehrt das um. Sie verbinden Ihre eigenen Anbieterschlüssel, Token werden Ihnen direkt vom Anbieter in Rechnung gestellt, und die Plattform erhebt keinen Aufschlag darauf. RolChat funktioniert auf diese Weise mit 62 Textmodellen von sieben Anbietern und 23 Sprachmodellen von vier Anbietern, insgesamt 85.
Bei einem eigenen Schlüssel verdoppelt eine Verbesserung, die das automatisierte Volumen verdoppelt, eine Anbieterrechnung, die Sie einsehen und verhandeln können. Bei gebündelten Guthaben verdoppelt dieselbe Verbesserung eine Rechnungsposition, deren Einzelpreis Sie nicht festlegen.
Token-Kosten folgen dem Kontext, nicht den Gesprächen
Teams, die neu mit ihrem eigenen Schlüssel arbeiten, erwarten meist, dass die Rechnung der Gesprächsanzahl folgt. Stattdessen folgt sie der Kontextlänge.
Eine Antwort, die aus den letzten vier Nachrichten entworfen wird, kostet einen Bruchteil derselben Antwort, die aus einem Thread mit sechzig Nachrichten entworfen wird, und eine Zusammenfassung dieses gesamten Threads kostet mehr als beides.
Drei Einstellungen machen daher den Großteil aus: wie weit das Kontextfenster zurückreicht, ob Zusammenfassungen bei jedem Thread oder nur bei langen laufen, und ob die Suche drei Hilfeartikel oder dreißig abruft.
Nichts davon ist auf einer Plan-Vergleichsseite sichtbar. Sichtbar ist es in der ersten Woche im Anbieter-Dashboard, was das Argument dafür ist, das Konto selbst zu verwalten.
Das passende Modell pro Aufgabe wählen
Ein einziges Modell für jede Aufgabe ist die teure Standardlösung. Die Arbeit lässt sich sauber danach aufteilen, wie viel Urteilsvermögen jede Aufgabe erfordert.
| Aufgabe | Erfordert | Sinnvolle Wahl |
|---|---|---|
| Tagging und Absicht | Geschwindigkeit, geringe Kosten, stabile Ausgabe | Ein kleines, schnelles Modell |
| Antwortentwurf | Ton, Schlussfolgerungen aus der Historie | Ein mittleres oder großes Modell |
| Richtlinien und Rückerstattungen | Sorgfalt, exakte Formulierung | Das stärkste verfügbare Modell |
| Übersetzung | Abdeckung Ihrer Sprachen | Der Anbieter mit der besten Abdeckung |
Diese Aufteilung senkt die Rechnung meist stärker als jede Prompt-Optimierung, weil die hochvolumigen Aufgaben die günstigen sind und das teure Modell nur dort läuft, wo es seinen Preis rechtfertigt.
Eine praktische Ausgangsaufteilung: schnelles Modell für Klassifizierung und Tagging, mittleres Modell für Entwürfe, das stärkste Modell reserviert für Geld- und Richtlinienfragen.
Routing-Änderungen, bevor überhaupt ein Entwurf geschrieben wird
Der größte sichtbare Gewinn entsteht, bevor jemand ein Wort schreibt. Die Klassifizierung erfolgt bei Eingang, sodass das Gespräch bereits getaggt, bereits in der richtigen Warteschlange und bereits mit einer Priorität versehen ist, wenn ein Mitarbeiter es öffnet.
Das beseitigt die Triage-Schicht - jenen Schritt, den Teams hinzufügen, wenn das Volumen wächst, und wieder streichen, wenn ihnen die Leute dafür ausgehen.
Es verändert auch, was ein SLA misst. Eine Uhr, die startet, wenn ein Mensch die Nachricht zum ersten Mal liest, belohnt Triage-Geschwindigkeit. Eine Uhr, die bei Eingang startet, belohnt das, was Kunden wirklich interessiert, und automatisierte Klassifizierung ist das, was die zweite Variante überhaupt tragbar macht.
Der zweite Effekt betrifft die Eskalation. Wenn Absicht und Stimmung bereits ab der ersten Nachricht erfasst sind, kann die Regel, die einen verärgerten Abrechnungs-Thread an einen erfahrenen Mitarbeiter weiterleitet, sofort greifen statt erst bei der zweiten Antwort.
In einer Demo lohnt es sich zu prüfen, ob die Klassifizierung bei Eingang oder erst beim ersten Öffnen läuft, denn nur Ersteres beseitigt den Triage-Schritt.
Daten, die der Assistent niemals erreichen sollte
Einen Assistenten auf den eigenen Inhalten aufzubauen bedeutet zu entscheiden, was als eigener Inhalt zählt. Gelöste Gespräche sind das nützlichste Trainingsmaterial und enthalten am ehesten Kartennummern und Ausweisdokumente, die Kunden in einen Chat eingefügt haben.
Drei Kontrollen tragen den Großteil der Verantwortung: Schwärzung, bevor irgendetwas das Modell erreicht, Aufbewahrungsfristen für Transkripte und eine Regel, dass der Assistent aus veröffentlichten Hilfeartikeln abruft, nicht aus rohen Threads.
Einwilligung gehört zur gleichen Entscheidung. RolChat behandelt sie als kostenpflichtiges Zusatzmodul für 5 $ pro Website, mit drei Einwilligungen pro Website, und es ist bei Lite nicht verfügbar.
Löschanfragen sind der Fall, der Teams am häufigsten überrascht. Ein aus dem Helpdesk entfernter Datensatz, der aber noch in einem Vektorindex liegt, ist immer noch ein Datensatz - prüfen Sie also, ob eine Löschung auch den Abruf erreicht und nicht nur die Ticketliste.
Antworten präzise und markenkonform halten
Zwei Einstellungen trennen Ausgaben, die Sie versenden können, von solchen, die Sie umschreiben müssen.
Die erste ist die Verankerung. Antworten werden aus freigegebenem Material entworfen: Hilfeartikel und gelöste Gespräche, und der Entwurf führt die genutzten Quellen mit. Eine Antwort ohne dahinterstehende Quelle ist eine Vermutung im selbstbewussten Tonfall.
Die zweite ist die Stimme. Eine Tonvorgabe und ein Glossar mit Begriffen, die Sie verwenden und nicht verwenden, sorgen dafür, dass Entwürfe wie Ihr Team klingen und nicht wie ein generischer Assistent.
Das Glossar ist über Sprachen hinweg noch wichtiger. Produktnamen und juristische Begriffe sind genau die Wörter, die eine Übersetzungsebene bereitwillig übersetzt, sofern man es ihr nicht untersagt.
RolChat deckt 40 Oberflächen- und Widget-Sprachen ab, und dasselbe Glossar gilt für alle davon.
Sprache: dieselbe Frage, eine engere Frist
Bei Sprachanwendungen steigt der Einsatz, weil es keinen Entwurf zur Prüfung gibt. Die Antwort wird gesprochen, während sie generiert wird, sodass die Verankerung im Voraus stimmen muss statt im Moment korrigiert zu werden.
Die praktische Aufteilung erfolgt nach Konsequenz. Sprache-zu-Text bei jedem Anruf, weil ein Transkript auch dann nützlich ist, wenn es unvollkommen ist. Gesprochene automatisierte Antworten nur dort, wo ein Fehler günstig ist: Öffnungszeiten, Status, Weiterleitung.
Anrufminuten werden bei RolChat separat vom Plan abgerechnet, sodass das Sprachvolumen ein Posten ist, den Sie eigenständig im Blick behalten, statt eine Überraschung innerhalb eines Sitzplatzpreises.
Die Reihenfolge der Einführung ist genauso wichtig wie die Einstellungen. Teams, die alles auf einmal aktivieren, können nicht erkennen, welche Änderung welche Kennzahl bewegt hat, und behalten am Ende entweder alles oder nichts davon.
Die Abfolge, die sich sauber liest: zuerst Klassifizierung, dann Entwürfe in einer Warteschlange, dann Entwürfe überall, dann jede autonome Abwicklung. Jeder Schritt hat sein eigenes Vorher und Nachher.
Messen, ob die Automatisierung funktioniert hat
Die Deflection-Rate ist die Kennzahl, mit der Anbieter werben, und zugleich die am wenigsten nützliche, weil ein Gespräch, das ohne Mensch endet, sowohl mit einer Antwort als auch damit enden kann, dass ein Kunde aufgibt.
Vier Zahlen sagen mehr aus. Die Bearbeitungsrate bei Entwürfen, die sinkt, wenn sich die Verankerung verbessert. Die erste Antwortzeit, in der sich der Copilot amortisiert. Die Wiedereröffnungsrate, die Antworten erfasst, die nur fertig aussahen. Die Kundenbewertung, aufgeschlüsselt nach automatisierter und menschlicher Bearbeitung.
Lesen Sie diese Zahlen im Verhältnis zur Anbieterrechnung derselben Periode. Qualität, die sich verbessert, während die Kosten pro Gespräch sinken, ist das Ergebnis, das sich zu behalten lohnt; jedes für sich allein nicht.
Alle vier Zahlen brauchen einen Messwert von vor der Einführung. Teams, die die Ausgangsbasis überspringen, streiten am Ende darüber, ob sich überhaupt etwas geändert hat, ohne dies klären zu können.
Grenzen, die man klar benennen sollte
Zwei Grenzen sollte man klar benennen. On-Premise-Bereitstellung ist eine Enterprise-Vereinbarung, nicht etwas, das bei den unteren Plänen verfügbar ist. Modelle, die auf eigener Hardware laufen, sind geplant, aber noch nicht verfügbar - eine heutige Anforderung an lokale Inferenz ist also eine Anforderung, die RolChat nicht erfüllt.
Die Preisgestaltung erfolgt pro Unternehmen statt pro Mitarbeiter, von 19 $ bei Lite bis Enterprise, das individuell bepreist wird, und die 30-tägige Testphase schaltet mit hinterlegter Karte jede Funktion frei.
Automatisierung lässt sich außerdem leichter beurteilen, wenn die dahinterliegenden Kanäle bereits an einem Ort gebündelt sind - das Thema des begleitenden Leitfadens.
Häufig gestellte Fragen
Was automatisiert Software für Kundenservice-Automatisierung tatsächlich?
Threads zusammenfassen, Antworten aus freigegebenen Inhalten entwerfen, Absicht klassifizieren, weiterleiten, taggen und übersetzen. Im Copilot-Muster bereitet sie all das vor, und ein Mitarbeiter entscheidet, was gesendet wird.
Wird KI Kundenservice-Mitarbeiter ersetzen?
Nicht im Copilot-Modell, dem Muster, das die meisten Teams verwenden sollten. Das Modell entwirft, der Mitarbeiter prüft und sendet. Was verschwindet, ist repetitive Vorbereitung, nicht die für die Antwort verantwortliche Person.
Was ist Bring-your-own-AI?
Sie verbinden Ihre eigenen Anbieterschlüssel, sodass Ihnen Token direkt vom Anbieter ohne Plattformaufschlag in Rechnung gestellt werden. Es bedeutet auch, dass Sie Modell oder Anbieter wechseln können, ohne den Helpdesk zu wechseln.
Wie viel kostet der Betrieb der KI?
Das hängt weit mehr von der Kontextlänge ab als von der Gesprächsanzahl. Lange Threads, Zusammenfassungen bei jedem Gespräch, breite Suchabrufe und wiederholtes erneutes Zusammenfassen sind die Einstellungen, die die Rechnung beeinflussen, und alle drei legen Sie selbst fest.
Welches Modell sollte welche Aufgabe übernehmen?
Ein kleines, schnelles Modell für Tagging und Absicht, ein mittleres oder großes Modell für Entwürfe und das stärkste verfügbare Modell für Rückerstattungen und Richtlinienformulierungen. Die Aufteilung nach Aufgabe spart meist mehr als Prompt-Optimierung.
Wie verhindert man, dass die KI Antworten erfindet?
Verankern Sie sie in freigegebenen Hilfeinhalten, sodass jeder Entwurf seine Quellen mitführt, behalten Sie den Prüfschritt bei und verfolgen Sie nach dem Start die Bearbeitungsrate und die Wiedereröffnungsrate statt nur die Deflection-Rate.
Können die Modelle auf unseren eigenen Servern laufen?
On-Premise-Bereitstellung ist bei Enterprise verfügbar. Selbst gehostete Modelle sind geplant, aber heute noch nicht verfügbar - eine feste Anforderung an lokale Inferenz wird derzeit also nicht erfüllt.
Funktioniert Automatisierung sprachübergreifend?
Ja. Sie deckt 40 Oberflächen- und Widget-Sprachen mit Übersetzung in beide Richtungen ab. Halten Sie Produkt- und Rechtsbegriffe in einem Glossar fest, damit die Übersetzungsebene sie unangetastet lässt.
Schreibt über Kundenservice-Prozesse, Live-Chat, KI-gestützten Support und die Werkzeuge hinter guter Kundenerfahrung.
LinkedIn