ChatGPT
 Perplexity
 Grok
 Claude
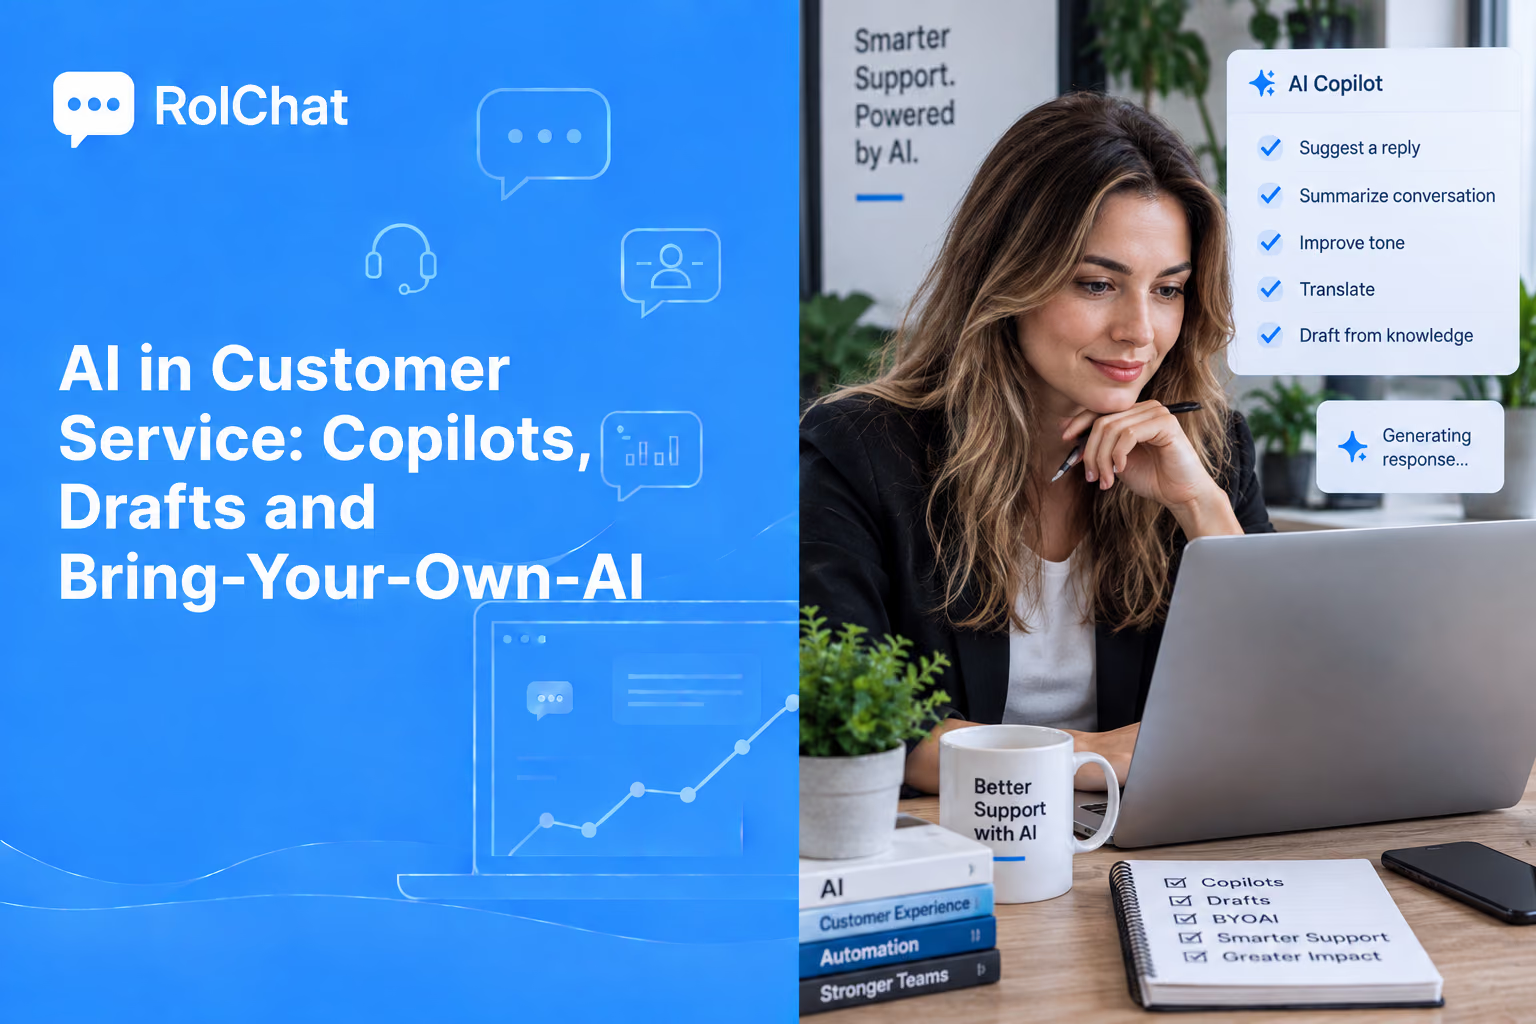
ग्राहक सेवा स्वचालन सॉफ़्टवेयर अब उस स्क्रिप्टेड बॉट से बहुत आगे निकल चुका है, जो सवाल को डिसीज़न ट्री से मिलाता था और शब्द बदलते ही हार मान लेता था। आज खरीदने लायक संस्करण एजेंट के बगल में बैठता है, पूरी बातचीत पढ़ता है, जवाब का ड्राफ़्ट तैयार करता है और जांच के लिए सौंप देता है।
इस बदलाव से खरीद का सवाल भी बदल जाता है। अब सवाल यह नहीं है कि टूल जवाब दे सकता है या नहीं, बल्कि यह है कि वह जवाब का कितना हिस्सा तैयार करता है, कितनी ज़िम्मेदारी इंसान के पास रहती है और वॉल्यूम बढ़ने पर मॉडल प्रदाता का भुगतान कौन करता है।
ग्राहक सेवा स्वचालन सॉफ़्टवेयर क्या करता है
इस श्रेणी के नाम के पीछे कुछ ठोस काम हैं। लंबी बातचीत को तीन पंक्तियों में समेटना। आपकी अपनी सहायता सामग्री के आधार पर जवाब का ड्राफ़्ट बनाना। इरादा पहचानकर उसी हिसाब से रूट करना। भावना पहचानना। दोनों दिशाओं में अनुवाद करना। बातचीत पर टैग लगाना, ताकि रिपोर्टिंग के पास गिनने को कुछ हो।
इनमें से कोई भी काम अपने आप में बड़ा नहीं लगता। लेकिन हर एक कोई न कोई देरी या हाथ से किया जाने वाला एक कदम हटा देता है, और ग्राहक इन्हीं देरियों को महसूस करते हैं।
इसका जुड़ता हुआ असर नए कर्मचारियों पर दिखता है। दूसरे हफ़्ते का कर्मचारी लगभग दूसरे साल वाले सहकर्मी के स्तर पर जवाब देता है, क्योंकि ड्राफ़्ट में पहले से नीति, खाते का इतिहास, सही लहजा और पिछले तीन ऑर्डर मौजूद होते हैं।
यहां स्वचालन का मतलब यह नहीं है कि जवाब डिफ़ॉल्ट रूप से बिना निगरानी के भेजे जाएं। नीचे की हर क्षमता यह मानकर चलती है कि भेजने से पहले कोई व्यक्ति ड्राफ़्ट देख सकता है, और प्लेटफ़ॉर्म इस तरह सेट किया जाता है कि यही सामान्य रास्ता हो, अपवाद नहीं।
स्वचालन के तीन स्तर, और कौन-सा खरीदें
वेंडर बिल्कुल अलग-अलग व्यवहार के लिए एक जैसे शब्द इस्तेमाल करते हैं, इसलिए स्तरों को इस आधार पर अलग करना उपयोगी है कि भेजे गए संदेश की ज़िम्मेदारी किसकी है।
| स्तर | कौन लिखता है | कौन भेजता है | कहां चूकता है |
|---|---|---|---|
| स्क्रिप्टेड फ़्लो | आप, पहले से | सिस्टम | सवाल न पहचान पाना |
| कोपायलट | मॉडल | एजेंट | जांच में एक क्लिक बेकार जाना |
| स्वायत्त एजेंट | मॉडल | सिस्टम | गलत जवाब भेज देना |
स्क्रिप्टेड फ़्लो अब भी उन सीमित, बार-बार आने वाले सवालों पर काम के हैं जिनके शब्द शायद ही बदलते हैं: ऑर्डर की स्थिति, खुलने का समय, पासवर्ड रीसेट।
बाकी सब के लिए कोपायलट डिफ़ॉल्ट विकल्प है, क्योंकि उसकी सबसे बुरी चूक की कीमत कुछ सेकंड है, जबकि स्वायत्त एजेंट की सबसे बुरी चूक की कीमत एक ग्राहक है।
ज़्यादातर टीमों के लिए सबसे अच्छा: सबसे ज़्यादा दोहराए जाने वाले पांच सवालों पर स्क्रिप्टेड फ़्लो, बाकी हर जगह कोपायलट, और स्वायत्त मोड सिर्फ़ वहां जहां गलत जवाब को पलटना सस्ता हो।
इनबॉक्स में कोपायलट मॉडल
कोपायलट के तरीके में मॉडल तैयारी करता है और फ़ैसला एजेंट लेता है। ड्राफ़्ट बातचीत के बगल में अपने स्रोतों के साथ दिखता है, और एजेंट उसे संपादित करता है, बदल देता है या भेज देता है।
जांच का कदम औपचारिकता नहीं है। यही वह नियंत्रण है जो कभी-कभार के गलत जवाब को ग्राहक के मेलबॉक्स तक पहुंचने के बजाय आपकी टीम के भीतर ही रोक लेता है।
इसी से यह संकेत भी मिलता है कि स्वचालन काम कर रहा है या नहीं। हर संपादन एक दर्ज सुधार है, और इन संपादनों की दर ही गुणवत्ता का ईमानदार पैमाना है, जिसका ज़िक्र आगे किया गया है।
जहां स्वचालन जवाब के बॉक्स से आगे जाता है
AI को लाइव चैट पर लगाया गया एक विजेट भर मान लेना उसकी ज़्यादातर क्षमता बर्बाद करना है। यही परत हर उस मॉड्यूल में काम करती है जो किसी बातचीत से जुड़ा है।
ज्ञान आधार में यह हल हो चुकी बातचीत से लेख के ड्राफ़्ट बनाता है और उन पेजों को चिह्नित करता है जो नए जवाबों से टकराते हैं। ग्राहक सहायता का ज्ञान आधार अगर कभी यह नहीं पकड़ता कि उसकी सामग्री पुरानी हो गई है, तो आम तौर पर यही वजह होती है कि सेल्फ़-सर्विस सवालों को रोकना बंद कर देती है।
रूटिंग में यह किसी इंसान से पहले इरादा पढ़ लेता है, इसलिए बिलिंग का सवाल बिना छंटाई के कदम से गुज़रे सीधे बिलिंग की कतार में पहुंचता है।
रिपोर्टिंग में यह बातचीत को उस टैग के आधार पर नहीं, जो किसी एजेंट को लगाना याद रहा, बल्कि इस आधार पर समूहों में बांटता है कि ग्राहकों ने असल में क्या पूछा। यही टिकटों की गिनती को प्रोडक्ट से जुड़े फ़ैसले में बदलता है।
आउटबाउंड काम में यही वर्गीकरण अभियान के सेगमेंट तय करता है, ताकि जिन लोगों ने अभी शिकायत की है, उन्हें अपसेल का ऑफ़र न पहुंचे।
मॉड्यूल में कवरेज से यह भी तय होता है कि सहायक आपकी अपनी सामग्री के कितने हिस्से तक पहुंच सकता है। जो सहायक सिर्फ़ मौजूदा चैट देखता है, वह सिर्फ़ उसी के आधार पर लिखता है; जो ग्राहक रिकॉर्ड, ऑर्डर का इतिहास और पिछले तीन टिकट देखता है, वह इन सब के आधार पर लिखता है।
अपना AI लाएं: मॉडल का खाता किसके पास है
लगभग हर डेमो में दो सवाल आपस में घुल-मिल जाते हैं। सहायक क्या कर सकता है, यह प्रोडक्ट का सवाल है। मॉडल प्रदाता के साथ खाता किसके पास है, यह व्यावसायिक सवाल है, और यही तय करता है कि बेहतर स्वचालन आपकी कुल लागत घटाएगा या बढ़ाएगा।
जब खाता प्लेटफ़ॉर्म के पास होता है, तो मॉडल का इस्तेमाल प्लेटफ़ॉर्म के बिल में अलग मद के रूप में आता है, आम तौर पर क्रेडिट या सीट के रूप में। तब लागत सफलता के साथ बढ़ती है: AI जितनी ज़्यादा बातचीत संभालता है, आप उतना ज़्यादा वेंडर से, वेंडर के मार्जिन पर खरीदते हैं।
अपना AI लाने का तरीका इसे उलट देता है। आप अपनी प्रदाता कुंजियां जोड़ते हैं, टोकन का बिल प्रदाता सीधे आपको भेजता है और प्लेटफ़ॉर्म उस पर कोई मार्कअप नहीं लेता। RolChat इसी तरह काम करता है - सात प्रदाताओं के टेक्स्ट मॉडल और चार प्रदाताओं के वॉइस मॉडल के साथ।
अपनी कुंजी के साथ, स्वचालित वॉल्यूम को दोगुना करने वाला सुधार उस प्रदाता बिल को दोगुना करता है जिसे आप देख सकते हैं और जिस पर मोलभाव कर सकते हैं। बंडल किए गए क्रेडिट के साथ, वही सुधार उस इनवॉइस की एक मद को दोगुना करता है जिसकी इकाई कीमत आप तय नहीं करते।
टोकन की लागत संदर्भ पर निर्भर है, बातचीत की गिनती पर नहीं
जो टीमें पहली बार अपनी कुंजी इस्तेमाल करती हैं, वे आम तौर पर मानती हैं कि बिल बातचीत की संख्या के साथ बढ़ेगा। असल में यह संदर्भ की लंबाई के साथ बढ़ता है।
पिछले चार संदेशों से बना जवाब का ड्राफ़्ट, साठ संदेशों वाली बातचीत से बने उसी जवाब की तुलना में बहुत कम खर्च करता है, और पूरी बातचीत का सारांश दोनों से ज़्यादा महंगा पड़ता है।
इसलिए ज़्यादातर असर तीन सेटिंग्स का होता है: संदर्भ विंडो कितना पीछे तक जाती है, सारांश हर बातचीत पर चलते हैं या सिर्फ़ लंबी बातचीत पर, और खोज तीन सहायता लेख खींचती है या तीस।
इनमें से कुछ भी प्लान की तुलना वाले पेज पर नहीं दिखता। यह पहले ही हफ़्ते में प्रदाता के डैशबोर्ड पर दिखता है, और यही खाता अपने पास रखने का तर्क है।
हर काम के लिए मॉडल चुनना
हर काम के लिए एक ही मॉडल रखना महंगा डिफ़ॉल्ट है। काम साफ़ तौर पर इस आधार पर बंट जाता है कि किस काम में कितनी समझ-बूझ चाहिए।
| काम | क्या चाहिए | समझदारी भरा चुनाव |
|---|---|---|
| टैगिंग और इरादा | रफ़्तार, कम लागत, स्थिर नतीजा | छोटा और तेज़ मॉडल |
| जवाब का ड्राफ़्ट | लहजा, इतिहास के आधार पर तर्क | मध्यम या बड़ा मॉडल |
| नीति और रिफ़ंड | सावधानी, सटीक शब्द | उपलब्ध सबसे सक्षम मॉडल |
| अनुवाद | आपकी भाषाओं का कवरेज | जो प्रदाता उन्हें सबसे अच्छी तरह कवर करे |
इस तरह बांटने से आम तौर पर बिल किसी भी प्रॉम्प्ट ट्यूनिंग से ज़्यादा घटता है, क्योंकि ज़्यादा वॉल्यूम वाले काम सस्ते होते हैं और महंगा मॉडल सिर्फ़ वहीं चलता है जहां वह अपनी कीमत वसूल करता है।
शुरुआत के लिए व्यावहारिक बंटवारा: वर्गीकरण और टैगिंग के लिए तेज़ मॉडल, ड्राफ़्ट के लिए मध्यम मॉडल, और पैसे व नीति से जुड़े कामों के लिए सबसे सक्षम मॉडल।
ड्राफ़्ट लिखे जाने से पहले ही रूटिंग बदल जाती है
दिखने वाला ज़्यादातर फ़ायदा किसी के एक शब्द लिखने से पहले ही मिल जाता है। वर्गीकरण बातचीत आते ही हो जाता है, इसलिए जब एजेंट उसे खोलता है, तब तक उस पर टैग लग चुका होता है, वह सही कतार में होती है और उसकी प्राथमिकता तय हो चुकी होती है।
इससे छंटाई की शिफ्ट खत्म हो जाती है - वह कदम जिसे टीमें वॉल्यूम बढ़ने पर जोड़ती हैं और लोग कम पड़ने पर हटा देती हैं।
इससे यह भी बदलता है कि SLA क्या मापता है। जो घड़ी किसी इंसान के पहली बार संदेश पढ़ने पर शुरू होती है, वह छंटाई की रफ़्तार को इनाम देती है। जो घड़ी संदेश आते ही शुरू होती है, वह उस चीज़ को इनाम देती है जिसकी ग्राहक परवाह करते हैं, और स्वचालित वर्गीकरण ही दूसरे तरीके को निभाने लायक बनाता है।
दूसरा असर एस्केलेशन पर पड़ता है। जब पहले संदेश से ही इरादा और भावना जुड़ी होती है, तो नाराज़ ग्राहक की बिलिंग वाली बातचीत को वरिष्ठ एजेंट तक पहुंचाने वाला नियम दूसरे जवाब का इंतज़ार किए बिना तुरंत चल सकता है।
डेमो में जांचने लायक: वर्गीकरण बातचीत आते ही चलता है या पहली बार खोलने पर, क्योंकि सिर्फ़ पहला तरीका छंटाई का कदम हटाता है।
वह डेटा जिस तक सहायक को कभी नहीं पहुंचना चाहिए
सहायक को अपनी सामग्री पर आधारित करने का मतलब है यह तय करना कि आपकी अपनी सामग्री क्या है। हल हो चुकी बातचीत सबसे उपयोगी सीखने की सामग्री होती है, और इसी में सबसे ज़्यादा संभावना होती है कि ग्राहकों ने चैट में कार्ड नंबर और पहचान दस्तावेज़ चिपकाए हों।
ज़्यादातर भार तीन नियंत्रण उठाते हैं: मॉडल तक कुछ भी पहुंचने से पहले संवेदनशील जानकारी हटाना, ट्रांसक्रिप्ट रखने की समय-सीमा, और यह नियम कि सहायक कच्ची बातचीत से नहीं, बल्कि प्रकाशित सहायता लेखों से जानकारी लेता है।
सहमति भी इसी फ़ैसले का हिस्सा है। RolChat हर प्लान पर, Lite सहित, सहमति प्रबंधन को प्रति साइट $5 के ऐड-ऑन के रूप में बेचता है।
डेटा हटाने के अनुरोध वह मामला है जिसमें टीमें अक्सर चूक जाती हैं। हेल्पडेस्क से हटाया गया लेकिन वेक्टर इंडेक्स में अब भी पड़ा रिकॉर्ड, रिकॉर्ड ही है, इसलिए जांचें कि हटाना सिर्फ़ टिकट सूची तक नहीं, खोज तक भी पहुंचता है।
जवाबों को सटीक और ब्रांड के अनुरूप रखना
दो सेटिंग्स तय करती हैं कि नतीजा भेजने लायक होगा या आपको उसे दोबारा लिखना पड़ेगा।
पहली है आधार। जवाब स्वीकृत सामग्री से ड्राफ़्ट किए जाते हैं - सहायता लेखों और हल हो चुकी बातचीत से - और ड्राफ़्ट के साथ वे स्रोत भी दिखते हैं जिनका उसने इस्तेमाल किया। जिस जवाब के पीछे कोई स्रोत नहीं, वह आत्मविश्वास भरे लहजे में किया गया अनुमान है।
दूसरी है आवाज़। लहजे की सेटिंग और उन शब्दों की शब्दावली जिन्हें आप इस्तेमाल करते हैं और नहीं करते, ड्राफ़्ट को किसी आम सहायक जैसा नहीं, बल्कि आपकी टीम जैसा बनाए रखती है।
कई भाषाओं में शब्दावली और भी अहम हो जाती है। प्रोडक्ट के नाम और कानूनी शब्द ठीक वही शब्द हैं जिन्हें अनुवाद की परत, मना न करने पर, बड़े उत्साह से अनुवाद कर देगी।
RolChat इंटरफ़ेस और विजेट की 40 भाषाओं को कवर करता है, और यही शब्दावली सभी पर लागू होती है।
वॉइस: वही सवाल, ज़्यादा कड़ी समय-सीमा
वॉइस में दांव ऊंचा होता है, क्योंकि जांचने के लिए कोई ड्राफ़्ट नहीं होता। जवाब बनते ही बोल दिया जाता है, इसलिए आधार को पहले से सही रखना होता है, मौके पर सुधारा नहीं जा सकता।
व्यावहारिक बंटवारा नतीजे के आधार पर होता है। हर कॉल पर स्पीच-टू-टेक्स्ट, क्योंकि ट्रांसक्रिप्ट अधूरा होने पर भी काम का होता है। बोले जाने वाले स्वचालित जवाब सिर्फ़ वहां जहां गलती सस्ती हो: समय, स्थिति, रूटिंग।
RolChat में टेलीफ़ोनी जल्द आ रही है, और तब कॉल मिनट का बिल प्लान से अलग आएगा, इसलिए वॉइस वॉल्यूम एक अलग मद होगा जिस पर आप अलग से नज़र रखेंगे, न कि सीट की कीमत में छिपा कोई झटका।
लागू करने का क्रम उतना ही मायने रखता है जितनी सेटिंग्स। जो टीमें सब कुछ एक साथ चालू कर देती हैं, वे यह नहीं बता पातीं कि किस बदलाव ने कौन-सा आंकड़ा बदला, और आखिर में या तो सब रखती हैं या कुछ भी नहीं।
साफ़ पढ़ा जा सकने वाला क्रम यह है: पहले वर्गीकरण, फिर एक कतार पर ड्राफ़्ट, फिर हर जगह ड्राफ़्ट, और उसके बाद ही कोई स्वायत्त संचालन। हर कदम का अपना पहले और बाद का आंकड़ा होता है।
कैसे मापें कि स्वचालन ने काम किया
डिफ़्लेक्शन दर वह पैमाना है जिससे वेंडर शुरुआत करते हैं, और यही सबसे कम उपयोगी है, क्योंकि बिना इंसान के खत्म हुई बातचीत का अंत जवाब से भी हो सकता है और ग्राहक के हार मान लेने से भी।
चार आंकड़े ज़्यादा बताते हैं। ड्राफ़्ट पर संपादन की दर, जो आधार बेहतर होने के साथ घटती है। पहले जवाब का समय, जहां कोपायलट अपनी कीमत वसूल करता है। दोबारा खुलने की दर, जो उन जवाबों को पकड़ती है जो सिर्फ़ पूरे दिखते थे। स्वचालित और मानवीय संचालन के हिसाब से बंटी ग्राहक रेटिंग।
इन्हें उसी अवधि के प्रदाता बिल के साथ पढ़ें। गुणवत्ता सुधरे और प्रति बातचीत लागत घटे, तभी नतीजा रखने लायक है; इनमें से कोई एक अकेले काफ़ी नहीं।
चारों आंकड़ों की रीडिंग लागू करने से पहले की होनी चाहिए। जो टीमें आधार रेखा छोड़ देती हैं, वे बाद में इस पर बहस करती रहती हैं कि कुछ बदला या नहीं, और इसे सुलझाने का कोई तरीका नहीं होता।
सीमाएं, जिन्हें साफ़ बताना ज़रूरी है
दो सीमाएं साफ़ बताना ज़रूरी है। ऑन-प्रिमाइस तैनाती Enterprise की व्यवस्था है, निचले प्लान पर यह उपलब्ध नहीं है। आपके अपने हार्डवेयर पर चलने वाले मॉडल अभी योजना में हैं, उपलब्ध नहीं, इसलिए अगर आज आपको स्थानीय इन्फ़रेंस चाहिए, तो RolChat यह शर्त पूरी नहीं करता।
कीमत प्रति एजेंट नहीं, प्रति कंपनी है: Lite पर $19 से शुरू, Enterprise की कीमत अनुरोध पर, और 30 दिन का मुफ़्त ट्रायल।
स्वचालन का आकलन भी तब आसान होता है जब उसके पीछे के चैनल पहले से एक जगह हों - यही साथी गाइड का विषय है।
अक्सर पूछे जाने वाले सवाल
ग्राहक सेवा स्वचालन सॉफ़्टवेयर असल में क्या स्वचालित करता है?
बातचीत का सारांश, स्वीकृत सामग्री से जवाब के ड्राफ़्ट, इरादे का वर्गीकरण, रूटिंग, टैगिंग और अनुवाद। कोपायलट के तरीके में यह सब तैयार करता है और क्या भेजा जाए, यह एजेंट तय करता है।
क्या AI ग्राहक सेवा एजेंटों की जगह ले लेगा?
कोपायलट मॉडल में नहीं, और ज़्यादातर टीमों को यही तरीका अपनाना चाहिए। मॉडल ड्राफ़्ट बनाता है, एजेंट जांचता है और भेजता है। गायब होती है दोहराव वाली तैयारी, न कि जवाब के लिए ज़िम्मेदार व्यक्ति।
अपना AI लाने का मतलब क्या है?
आप अपनी प्रदाता कुंजियां जोड़ते हैं, इसलिए टोकन का बिल प्रदाता सीधे आपको भेजता है और प्लेटफ़ॉर्म कोई मार्कअप नहीं लेता। इसका यह भी मतलब है कि आप हेल्पडेस्क बदले बिना मॉडल या प्रदाता बदल सकते हैं।
AI चलाने में कितना खर्च आता है?
यह बातचीत की संख्या से कहीं ज़्यादा संदर्भ की लंबाई पर निर्भर है। लंबी बातचीत, हर बातचीत पर सारांश, चौड़ी खोज और बार-बार दोबारा सारांश - यही सेटिंग्स बिल बदलती हैं, और तीनों आपके हाथ में हैं।
कौन-सा मॉडल कौन-सा काम संभाले?
टैगिंग और इरादे के लिए छोटा तेज़ मॉडल, ड्राफ़्ट के लिए मध्यम या बड़ा मॉडल, और रिफ़ंड व नीति के शब्दों के लिए उपलब्ध सबसे सक्षम मॉडल। काम के हिसाब से बांटना आम तौर पर प्रॉम्प्ट ट्यूनिंग से ज़्यादा बचत करता है।
AI को जवाब गढ़ने से कैसे रोकें?
उसे स्वीकृत सहायता सामग्री पर आधारित रखें ताकि हर ड्राफ़्ट के साथ उसके स्रोत हों, जांच का कदम बनाए रखें, और लॉन्च के बाद सिर्फ़ डिफ़्लेक्शन नहीं, बल्कि संपादन दर और दोबारा खुलने की दर पर नज़र रखें।
क्या मॉडल हमारे अपने सर्वर पर चल सकते हैं?
ऑन-प्रिमाइस तैनाती Enterprise पर उपलब्ध है। सेल्फ़-होस्टेड मॉडल अभी योजना में हैं, आज उपलब्ध नहीं, इसलिए स्थानीय इन्फ़रेंस की सख़्त ज़रूरत फ़िलहाल पूरी नहीं होती।
क्या स्वचालन कई भाषाओं में काम करता है?
हां। यह इंटरफ़ेस और विजेट की 40 भाषाओं को कवर करता है, दोनों दिशाओं में अनुवाद के साथ। प्रोडक्ट और कानूनी शब्दों को शब्दावली में रखें, ताकि अनुवाद की परत उन्हें न छुए।
कस्टमर सपोर्ट ऑपरेशंस, लाइव चैट, AI-सहायित सेवा और बेहतरीन ग्राहक अनुभव के पीछे के टूल्स पर लिखते हैं।
LinkedIn