El software de automatización de servicio al cliente ha superado al bot con guion que comparaba una pregunta con un árbol de decisiones y se rendía cuando cambiaba la redacción. La versión que vale la pena comprar ahora se sienta junto al agente, lee todo el hilo, redacta una respuesta y la entrega para revisión.
Ese cambio transforma la pregunta de compra. Ya no se trata de si la herramienta puede responder, sino de cuánta parte de la respuesta prepara, cuánta sigue siendo responsabilidad de una persona, y quién paga al proveedor del modelo cuando crece el volumen.
Qué hace el software de automatización de servicio al cliente
Detrás del nombre de la categoría hay una lista corta de tareas concretas. Resumir un hilo largo en tres líneas. Redactar una respuesta basada en tu propio contenido de ayuda. Clasificar la intención y enrutar en consecuencia. Detectar el sentimiento. Traducir en ambas direcciones. Etiquetar la conversación para que los informes tengan algo que contar.
Ninguna de esas tareas es dramática por sí sola. Cada una elimina una demora o un paso manual, y las demoras son lo que sienten los clientes.
El efecto acumulativo se nota con las nuevas contrataciones. Una persona en su segunda semana responde casi al nivel de alguien en su segundo año, porque el borrador ya lleva la política, el historial de la cuenta, el tono correcto y los últimos tres pedidos.
La automatización aquí no significa respuestas sin supervisión por defecto. Cada capacidad a continuación asume que una persona puede ver el borrador antes de que se envíe, y la plataforma está configurada para que ese sea el camino normal y no la excepción.
Tres niveles de automatización, y cuál comprar
Los proveedores usan las mismas palabras para comportamientos muy diferentes, así que ayuda separar los niveles según quién es responsable del mensaje enviado.
| Nivel | Quién escribe | Quién envía | Falla por |
|---|---|---|---|
| Flujo con guion | Tú, de antemano | El sistema | No reconocer la pregunta |
| Copiloto | El modelo | El agente | Desperdiciar un clic de revisión |
| Agente autónomo | El modelo | El sistema | Enviar una respuesta incorrecta |
Los flujos con guion todavía se ganan su lugar en las preguntas estrechas y de alto volumen donde la redacción apenas varía: estado del pedido, horario de atención, restablecimiento de contraseñas.
El copiloto es la opción predeterminada para todo lo demás, porque su peor resultado cuesta unos segundos y el peor resultado del agente autónomo le cuesta un cliente.
Lo mejor para la mayoría de los equipos: flujos con guion en las cinco preguntas repetidas principales, copiloto en todo lo demás, autónomo solo donde una respuesta incorrecta sea fácil de revertir.
El modelo de copiloto en la bandeja de entrada
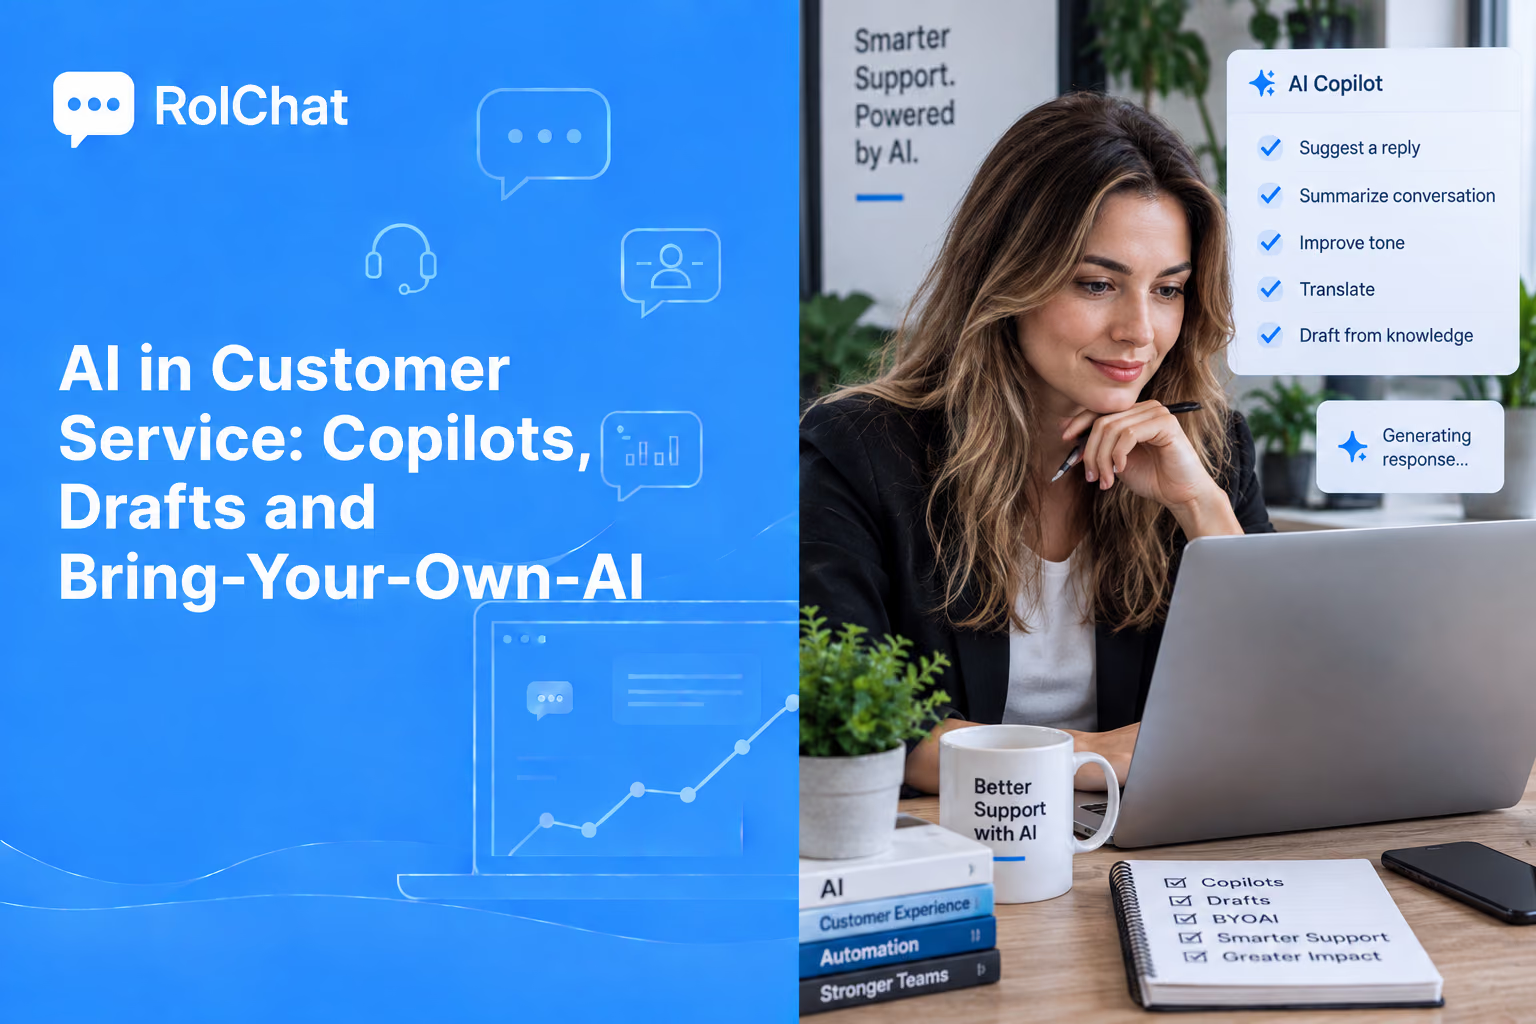
En el patrón de copiloto, el modelo prepara y el agente decide. El borrador aparece junto a la conversación con sus fuentes adjuntas, y el agente lo edita, lo reemplaza o lo envía.
El paso de revisión no es una formalidad. Es el control que mantiene una respuesta ocasionalmente incorrecta dentro de tu empresa en lugar de en la bandeja de entrada de tu cliente.
También produce la señal que te indica si la automatización está funcionando. Cada edición es una corrección etiquetada, y la tasa de esas ediciones es la métrica de calidad honesta que se describe más adelante.
Dónde llega la automatización más allá del cuadro de respuesta
Tratar la IA como un widget añadido al chat en vivo desperdicia la mayor parte de su potencial. Esa misma capa tiene trabajo que hacer en cada módulo que toca una conversación.
En la base de conocimientos redacta artículos a partir de hilos resueltos y marca las páginas que contradicen respuestas más recientes. El software de base de conocimientos de atención al cliente que nunca nota su propia obsolescencia es la razón habitual por la que el autoservicio deja de desviar nada.
En el enrutamiento lee la intención antes de que lo haga una persona, de modo que una pregunta de facturación llegue a la cola de facturación sin pasar por un paso de triaje.
En los informes agrupa las conversaciones según lo que realmente preguntaron los clientes en lugar de la etiqueta que un agente recordó aplicar, que es lo que convierte un recuento de tickets en una decisión de producto.
En el trabajo saliente, la misma clasificación impulsa los segmentos de campaña, de modo que las personas que acaban de quejarse no sean las que reciben la venta adicional.
La cobertura entre módulos también decide cuánto de tu propio material puede alcanzar el asistente. Un asistente que solo ve el chat actual escribe a partir del chat actual, y un asistente que ve el registro del cliente, el historial de pedidos y los últimos tres tickets escribe a partir de todo eso.
Trae tu propia IA: quién posee la cuenta del modelo
Dos preguntas se mezclan en casi todas las demostraciones. Lo que el asistente puede hacer es una pregunta de producto. Quién posee la cuenta con el proveedor del modelo es una pregunta comercial, y decide si una mejor automatización reduce tu costo total o lo aumenta.
Cuando la plataforma posee la cuenta, el uso del modelo llega como una partida de la plataforma, generalmente en forma de créditos o asientos. El costo entonces sube con el éxito: cuantas más conversaciones gestiona la IA, más compras al proveedor con el margen del proveedor.
Trae tu propia IA invierte eso. Conectas tus propias claves de proveedor, el proveedor te factura los tokens directamente, y la plataforma no cobra ningún margen sobre ellos. RolChat funciona así en 62 modelos de texto de siete proveedores y 23 modelos de voz de cuatro, 85 en total.
Con una clave propia, una mejora que duplica el volumen automatizado duplica una factura del proveedor que puedes ver y negociar. Con créditos incluidos, esa misma mejora duplica una línea en una factura cuyo precio unitario no defines tú.
El costo de tokens sigue al contexto, no a las conversaciones
Los equipos nuevos con su propia clave suelen esperar que la factura siga el número de conversaciones. En cambio, sigue la longitud del contexto.
Una respuesta redactada a partir de los últimos cuatro mensajes cuesta una fracción de la misma respuesta redactada a partir de un hilo de sesenta, y un resumen de todo ese hilo cuesta más que cualquiera de los dos.
Tres configuraciones hacen la mayor parte del trabajo: hasta dónde llega la ventana de contexto, si los resúmenes se ejecutan en cada hilo o solo en los largos, y si la recuperación extrae tres artículos de ayuda o treinta.
Nada de eso es visible en una página de comparación de planes. Es visible en el panel del proveedor durante la primera semana, lo cual es el argumento a favor de poseer la cuenta tú mismo.
Elegir un modelo por tarea
Un solo modelo para cada trabajo es la opción predeterminada más cara. El trabajo se divide claramente según cuánto juicio requiere cada tarea.
| Tarea | Requiere | Elección sensata |
|---|---|---|
| Etiquetado e intención | Velocidad, bajo costo, salida estable | Un modelo pequeño y rápido |
| Redacción de respuestas | Tono, razonamiento sobre el historial | Un modelo mediano o grande |
| Política y reembolsos | Cuidado, redacción exacta | El modelo más potente disponible |
| Traducción | Cobertura de tus idiomas | El proveedor que mejor los cubra |
Dividir de esta manera suele reducir la factura más que cualquier ajuste de prompts, porque las tareas de alto volumen son las económicas y el modelo caro solo se ejecuta donde justifica su precio.
Una división práctica de partida: modelo rápido para clasificación y etiquetado, modelo mediano para borradores, modelo más potente reservado para dinero y política.
Los cambios de enrutamiento ocurren antes de escribir cualquier borrador
La mayor parte de la ganancia visible se produce antes de que alguien escriba una palabra. La clasificación ocurre al llegar, de modo que la conversación ya está etiquetada, ya está en la cola correcta y ya lleva una prioridad cuando un agente la abre.
Eso elimina el turno de triaje, que es el paso que los equipos añaden cuando crece el volumen y eliminan cuando se quedan sin personas para hacerlo.
También cambia lo que mide un SLA. Un reloj que empieza cuando una persona lee el mensaje por primera vez premia la velocidad del triaje. Un reloj que empieza al llegar premia lo que le importa al cliente, y la clasificación automatizada es lo que hace que el segundo sea sostenible.
El segundo efecto está en la escalación. Cuando la intención y el sentimiento se adjuntan desde el primer mensaje, la regla que envía un hilo de facturación enfadado a un agente senior puede activarse de inmediato en lugar de en la segunda respuesta.
Vale la pena comprobar en una demostración: si la clasificación se ejecuta al llegar o al abrir por primera vez, porque solo la primera elimina el paso de triaje.
Datos a los que el asistente nunca debe acceder
Fundamentar un asistente en tu propio contenido significa decidir qué cuenta como contenido propio. Las conversaciones resueltas son el material de entrenamiento más útil y el más propenso a contener números de tarjetas y documentos de identidad que los clientes pegaron en un chat.
Tres controles llevan la mayor parte del peso: redacción antes de que nada llegue al modelo, límites de retención en las transcripciones, y una regla según la cual el asistente recupera información de artículos de ayuda publicados y no de hilos sin procesar.
El consentimiento pertenece a la misma decisión. RolChat lo gestiona como un complemento de pago a $5 por sitio, con tres consentimientos por sitio, y no está disponible en Lite.
Las solicitudes de eliminación son el caso que sorprende a los equipos. Un registro eliminado del helpdesk pero que todavía está en un índice vectorial sigue siendo un registro, así que comprueba que una eliminación llegue a la recuperación y no solo a la lista de tickets.
Mantener las respuestas precisas y fieles a la marca
Dos configuraciones separan la salida que puedes enviar de la que tienes que reescribir.
La primera es la fundamentación. Las respuestas se redactan a partir de material aprobado: artículos de ayuda y conversaciones resueltas, y el borrador lleva las fuentes que utilizó. Una respuesta sin ninguna fuente detrás es una suposición con un tono seguro.
La segunda es la voz. Una configuración de tono y un glosario de términos que usas y que no usas mantienen los borradores sonando como tu equipo en lugar de como un asistente genérico.
El glosario importa más entre idiomas. Los nombres de producto y los términos legales son exactamente las palabras que una capa de traducción traducirá amablemente a menos que se le indique lo contrario.
RolChat cubre 40 idiomas de interfaz y widget, y el mismo glosario se aplica a todos ellos.
Voz: la misma pregunta, un plazo más exigente
La voz eleva las apuestas porque no hay ningún borrador que revisar. La respuesta se habla a medida que se genera, así que la fundamentación tiene que estar bien de antemano en lugar de corregirse en el momento.
La división práctica es por consecuencia. Voz a texto en cada llamada, porque una transcripción es útil incluso cuando es imperfecta. Respuestas automatizadas habladas solo donde equivocarse sale barato: horarios, estado, enrutamiento.
Los minutos de llamada se facturan por separado del plan en RolChat, así que el volumen de voz es una partida que vigilas por su cuenta en lugar de una sorpresa dentro de un precio por asiento.
El orden de implementación importa tanto como las configuraciones. Los equipos que activan todo a la vez no pueden saber qué cambio movió qué número, y terminan manteniendo todo o nada de ello.
La secuencia que se entiende con claridad es primero la clasificación, luego los borradores en una sola cola, después los borradores en todas partes, y finalmente cualquier gestión autónoma. Cada paso tiene su propio antes y después.
Medir si la automatización funcionó
La tasa de desvío es la métrica con la que lideran los proveedores y la menos útil, porque una conversación que termina sin un humano puede terminar en una respuesta o en un cliente que se rinde.
Cuatro números dicen más. La tasa de edición en los borradores, que disminuye a medida que mejora la fundamentación. El tiempo de primera respuesta, que es donde el copiloto se paga solo. La tasa de reapertura, que detecta respuestas que solo parecían terminadas. La calificación del cliente dividida entre gestión automatizada y humana.
Léelos junto a la factura del proveedor del mismo período. Una calidad que mejora mientras el costo por conversación baja es el resultado que vale la pena mantener; cualquiera de los dos por sí solo no lo es.
Los cuatro números necesitan una lectura de antes de la implementación. Los equipos que se saltan la línea base terminan discutiendo si algo cambió, sin forma de resolverlo.
Límites que vale la pena declarar con claridad
Vale la pena declarar dos límites con claridad. El despliegue en local es un acuerdo de Enterprise, no algo disponible en los planes inferiores. Los modelos que se ejecutan en tu propio hardware están planificados en lugar de disponibles, así que un requisito de inferencia local hoy es un requisito que RolChat no cumple.
El precio es por empresa en lugar de por agente, desde $19 en Lite; Enterprise se cotiza de forma individual, y la prueba de 30 días abre todas las funciones con una tarjeta registrada.
La automatización también es más fácil de evaluar una vez que los canales que hay detrás ya están en un solo lugar, que es el tema de la guía complementaria.
Preguntas frecuentes
¿Qué automatiza en realidad el software de automatización de servicio al cliente?
Resumir hilos, redactar respuestas a partir de contenido aprobado, clasificar la intención, enrutar, etiquetar y traducir. En el patrón de copiloto prepara todo eso y un agente decide qué se envía.
¿La IA reemplazará a los agentes de servicio al cliente?
No en el modelo de copiloto, que es el patrón que la mayoría de los equipos debería seguir. El modelo redacta y el agente revisa y envía. Lo que desaparece es la preparación repetitiva, no la persona responsable de la respuesta.
¿Qué es traer tu propia IA?
Conectas tus propias claves de proveedor, de modo que el proveedor te factura los tokens directamente sin margen de la plataforma. También significa que puedes cambiar de modelo o de proveedor sin cambiar de helpdesk.
¿Cuánto cuesta ejecutar la IA?
Depende mucho más de la longitud del contexto que del número de conversaciones. Los hilos largos, los resúmenes en cada conversación, la recuperación amplia y el resumen repetido son las configuraciones que mueven la factura, y las tres son tuyas para definir.
¿Qué modelo debería encargarse de qué tarea?
Un modelo pequeño y rápido para etiquetado e intención, un modelo mediano o grande para borradores, y el modelo más potente disponible para reembolsos y redacción de políticas. Dividir por tarea suele ahorrar más que ajustar los prompts.
¿Cómo se evita que la IA invente respuestas?
Fundaméntala en contenido de ayuda aprobado para que cada borrador lleve sus fuentes, mantén el paso de revisión y controla la tasa de edición y la tasa de reapertura después del lanzamiento en lugar de solo el desvío.
¿Pueden los modelos ejecutarse en nuestros propios servidores?
El despliegue en local está disponible en Enterprise. Los modelos autoalojados están planificados en lugar de disponibles hoy, así que un requisito estricto de inferencia local aún no se cumple.
¿La automatización funciona en varios idiomas?
Sí. Cubre 40 idiomas de interfaz y widget, con traducción en ambas direcciones. Mantén los términos de producto y legales en un glosario para que la capa de traducción los deje intactos.
Escribe sobre operaciones de atención al cliente, chat en vivo, servicio asistido por IA y las herramientas detrás de una buena experiencia de cliente.
LinkedIn